Tout le monde a certainement déjà entendu parler de la bactérie Escherichia Coli, au moins dernièrement lors de cas d’intoxications alimentaires par certaines souches. Mais la plupart d’entre-elles sont inoffensives, voire bénéfiques, puisque nous en avons tous environ 1 milliard dans nos intestins.
Le contexte
L’avantage d’une expérience sur des bactéries est que leur cycle de reproduction se mesure en heures (voire en minutes). Le bactériologiste Richard Lenski et ses collègues de l’université du Michigan ont tiré parti de ce fait, en réalisant des essais contrôlés en laboratoire.
L’expérience a débuté en 1988. Lenski a pris une population d’E.Coli et a infecté douze flacons par des colonies identiques, tous remplis d’un liquide nutritif de même composition, riche en glucose. Au départ on avait donc douze flacons identiques, possédant des populations identiques.
(Enfin, presque identique car les bactéries possèdent un gène nommé Ara, qui se présente sous deux formes Ara+ et Ara-. Sans trop rentrer dans les détails, la différence entre ces deux allèles ne se voit que lorsque l’on ensemence les bactéries avec un mélange d’arabinose [sucre] et d’un colorant chimique, le tétrazolium. Les bactéries Ara+ se voient sous forme de colonies blanches alors que les bactéries Ara- se voient sous forme de colonies rouges. Ce gène constitue en quelque sorte un marqueur de couleur. Lenski et son équipe ont en fait organisé leurs populations de bactéries de façon à ce que six de leurs tribus possédaient l’allèle Ara+ et les six autres Ara-. Ainsi ils prenaient soin de manipuler alternativement les flacons Ara+ et Ara-, ce qui leur permettait de voir s’ils avaient fait une erreur de manipulation, par éclaboussure par exemple. Mais cela avait également une autre utilité fondamentale que l’on verra plus tard…)
Ces flacons ont ensuite été placés dans un incubateur-agitateur, ce qui permettait de maintenir les bactéries bien au chaud et de les agiter pour qu’elles restent bien réparties dans le liquide.
Mais chaque jour, pour chacune des douze “tribus”, un nouveau flacon vierge était infecté du flacon de la veille. Un petit échantillon, précisément le centième du volume de l’ancien flacon, était prélevé et placé dans le nouveau qui contenait une nouvelle réserve de liquide nutritif riche en glucose. La population de bactérie dans le nouveau flacon augmentait alors très rapidement, jusqu’à stagner le lendemain, quand la réserve de nourriture s’épuisait. Et à ce moment-là un nouvel échantillon était prélevé, et le cycle recommençait le lendemain
L’expérience ayant duré près de vingt-cinq années, imaginez donc le nombre de flacons utilisés: douze rangées de plus de huit milles flacons! Et si l’on considère une moyenne de 6 à 7 générations de bactéries par jour, cela donne environ 55 000 générations de bactéries (Le cap des 50 000 ayant été atteint en février 2010)
Pour chaque flacon étaient également prélevés des échantillons, destinés à être analysés afin de voir comment progressait l’évolution, mais aussi des échantillons étaient congelés et l’on verra plus tard leur utilité.
Les premiers résultats
Le décor étant posé, la question intéressante de cette expérience était de savoir si les nouvelles générations de bactéries resteraient identiques à leurs ancêtres, ou bien si elles évolueraient. Et si elles évoluaient, est-ce que les douze colonies évolueraient de la même façon ou selon des schémas différents?
Comme dit précédemment, le liquide nutritif contenait du glucose. Ce n’était pas le seul aliment s’y trouvant, mais c’était la ressource limitante. C’était le facteur qui limitait la taille de la population. Ainsi, si une mutation devait survenir sur une bactérie, permettant à celle-ci d’exploiter le glucose plus efficacement, on devrait s’attendre à ce que, grâce à la sélection naturelle, les individus mutants se reproduisent statistiquement mieux que les non-mutants. Et donc ce nouveau type de bactérie devrait se retrouver de plus en plus souvent dans les flacons, jusqu’à retrouver des bactéries de plus en plus efficace à l’exploitation du glucose.
Hé bien, c’est exactement ce qui s’est passé dans les douze lignées de flacons. Elles ont su de mieux en mieux utiliser le glucose. Mais le point le plus intéressant à relever, est qu’elles l’ont fait selon des modes différents! C’est à dire qu’elles se sont développées grâce à des mutations différentes… Pour le savoir, les chercheurs ont comparé la fitness (=”valeur sélective” en français, c’est une mesure de la réussite reproductive) de chaque échantillon aux populations “fossiles” échantillonnées dans la population fondatrice d’origine. D’où l’utilité de la congélation d’échantillons mentionnée précédemment… Ces échantillons “fossiles”, une fois décongelés, se remettent à vivre et à se reproduire normalement.
Ainsi Lenski et son équipe, ont placé dans un flacon vierge un échantillon de la population supposée évoluée avec une échantillon de la population ancestrale décongelée. Cela donne donc un nouveau flacon expérimental, contenant deux souches en concurrence. Et pour pouvoir distinguer laquelle de ces populations va dépasser l’autre, Lenski a pu utiliser la propriété du gène Ara: En mélangeant une population Ara- avec une population Ara+, il devient très facile de voir quelle population l’emporte grâce à leur différence de couleur en ensemençant les bactéries avec le mélange d’arabinose et tétrazolium (Bien sûr des travaux antérieurs avaient montré que les allèles Ara n’avaient aucune influence sur la fitness).
Ainsi la fitness moyenne des douze populations a augmenté au fil des milliers de générations, elles ont toutes amélioré leur capacité de survie dans une situation limite de glucose, et leur taille corporelle moyenne. Si l’on regarde l’évolution de la taille corporelle pour une lignée, la courbe d’évolution ressemble de très près à une hyperbole, c’est à dire que, grosso-modo, la courbe montre que la plus grande augmentation de la taille corporelle se produit dans les 2000 premières générations environ puis semble tendre vers un plateau. Mais ce qui est intéressant, c’est que si l’on compare les 12 courbes d’évolution, on remarque que l’évolution des tailles est assez différents pour chacune. Elles donnent toutes l’impression de s’approcher d’un plateau, mais le plus élevé des douze plateaux est presque deux fois plus élevé que le moins élevé.
De plus, les courbes ont des formes différentes, car celle qui atteint la valeur la plus élevée à la génération 10 000, commence par augmenter plus lentement que certaines autres, puis les dépasse toutes avant la génération 7000.
Tout cela laisse donc penser que dans le cas présent, devenir plus gros présente un avantage pour survivre dans cet environnement alternativement riche et pauvre en glucose. Peu importe quelle en est la raison, mais on a en tout cas l’impression qu’il fallait qu’il en soit ainsi puisque c’est ce qu’il s’est produit dans les douze lignées différentes. Quoi qu’il en soit, il n’existe pas une façon unique de grossir, différents ensembles de mutations peuvent en être responsable. C’est ce que montrent les différentes courbes
Jusqu’ici, cette expérience de Lenski et de ses collègues universitaires montre donc la réalité de l’évolution. Mais la suite va révéler un résultat encore plus surprenant et qui va conforter cette réalité.
Mais le plus surprenant reste à venir…
Pour résumer, je vous ai dit que dans les douze lignées, une amélioration de la fitness avait été observée, et que cette évolution s’est faite de la même façon avec simplement des différences dans les détails (Plus lentement chez certaines tribus, plus rapides chez d’autres).
Mais un peu après la génération 33 000, quelque chose de très surprenant s’est produit: Une des douze lignées (qui portait le nom d’Ara-3) a vu sa densité de population maximale (le plateau qu’on atteint une fois les ressources épuisées) totalement exploser! Pour vous donner des chiffres un peu parlants, on va prendre la densité optique, qui est une mesure de la population. Avant la génération 33 000 cette densité optique était sensiblement constante autour de 0,04 (peu importe ce que signifie cette valeur, ce n’est pas important ici) Puis juste après la génération 33 000, pour la population Ara-3, la densité optique est passée en quelques dizaines de générations à 0,25, soit six fois plus! C’était comme si on avait rajouté du glucose dans les flacons des colonies Ara-3. Mais ce n’était pas le cas.
Alors que s’est-il passé dans la population Ara-3?
Lenski a bien sûr cherché à la savoir, et il a trouvé. Vous vous souvenez que le glucose est la ressource limitant l’expansion des populations dans les flacons, mais le glucose n’était pas le seul nutriment présent. Il y en avait un autre qui est du citrate (apparenté à la substance qui rend les citrons acides). Le liquide contenait beaucoup de citrate, et normalement E. Coli ne peut pas l’utiliser (du moins pas en présence d’oxygène). Mais la tribu Ara-3 a tout à coup acquis l’aptitude d’absorber le citrate aussi bien que le glucose. La quantité de nourriture disponible dans chaque flacon a donc considérablement augmenté
La question qui en découlait, était de savoir quelle(s) mutation(s) avai(en)t conduit à cette situation.
Lenski a émis l’hypothèse que cela était dû à au moins 2 mutations (il avait calculé que 30 000 générations était suffisantes pour que chaque gène ait muté au moins une fois dans chacune des douze lignées, et donc que si cela était dû à une seule mutation, il est probable que d’autres tribus auraient acquis la même capacité). On va appeler, pour simplifier, ces mutation A et B. Pour que la capacité d’absorber le citrate se manifeste, il faut vraiment qu’il y ait les deux mutations.
L’hypothèse de Lenski est donc qu’à un certain moment inconnu, la tribu Ara-3 aurait subi la mutation A qui n’a pas donné d’effet décelable, puis plus tard l’autre mutation nécessaire, la mutation B. Il est probable que la mutation A ou la mutation B ait pu apparaître dans n’importe laquelle des autres tribus, cela s’est certainement produit, mais les deux mutations seraient présentes uniquement dans la tribu Ara-3 à partir de la génération 33 000.
Un des élèves de Lenski s’est alors vu attribuer une tâche assez pénible, qui était de vérifier cette hypothèse en retrouvant le moment où aurait eu lieu la première mutation. Pour cela il fallait décongeler les échantillons des tribus ancestrales, et observer celles pour qui la probabilité de “découvrir” comment gérer le citrate, est la plus élevée. Il a ainsi été montré que la première mutation a eu lieu approximativement à la génération 20 000. Tous les clones décongelés après la génération 20 000 ont montré une plus grande probabilité d’acquérir la capacité d’absorber le citrate, cette probabilité est d’ailleurs la même pour toutes les générations du moment qu’elles datent d’après la génération 20 000.
En conclusion…
Ce travail effectué par Lenski et son équipe montre un grand nombre des composants essentiels de l’évolution: Les mutations aléatoires soumises à une sélection naturelle non aléatoire, l’adaptation à un environnement par des voies différentes, la façon dont des mutations successives peuvent s’additionner pour opérer une modification évolutive, ou encore que certains gènes ont besoin d’autres gènes pour s’exprimer.
Vous comprendrez donc pourquoi cette expérience qui fait voler en éclat le dogme de la complexité irréductible n’est jamais évoquée par ses détracteurs…
Sources:
– “Le plus grand spectacle du monde”, Richard Dawkins
Je vais donc essayer de vous parler de l’introduction du tirage au sort dans les systèmes de décisions collectives. A première vue l’idée semble absurde et le hasard semble être le choix le moins instinctif et le moins rationnel. Et pourtant cette option, appelé Stochocratie depuis la fin des années 90 a des militants en France.
Je vais tenter en quelques minutes de faire trois choses :
Vous présenter rapidement l’origine cette idée sans prétendre le moins du monde être exhaustif
Ensuite vous expliquer qu’elle mérite considération
Enfin vous montrer qu’elle pose elle aussi un certain nombre de problèmes
Les origines de l’idée
Comme vous le savez sûrement le tirage au sort des dirigeant était utilisé dans la démocratie athénienne. Même si cela ne concernait que certains dirigeants. Dans la définition que donne Aristote de la démocratie (qu’il ne portait pas vraiment dans son coeur) il y fait d’ailleurs explicitement référence. L’usage du tirage au sort à l’époque de la grandeur d’Athènes était malgré tout grandement limité. Plus tard, le même système a, semble-t-il, été largement utilisé dans les république de Venise et Florence.
De façon plus contemporaine, on utilise, à l’heure actuelle, dans de nombreux pays le tirage au sort pour désigner des jurés lors de procès. Et aussi parfois, en cas de faible disponibilité d’un médicament ou dans des cas de transfert d’organes.
En France son militant le plus actif et sans doute le plus radical est sûrement Etienne Chouard. Je précise tout de suite que pour moi Etienne Chouard est un personnage plus que contestable. C’est un professeur de lycée qui s’est rendu célèbre en écrivant un texte appelant à voter contre le traité constitutionnel européen de 2005 ce que je ne porte pas à son crédit. Il a par la suite relayé certaines thèses des conspirationistes du 11 septembre. Malgré cela sa défense du tirage au sort en politique mérite, il me semble d’être considérée.
les avantages de ce système
Déjà un petit mot sur quelque chose que je ne vais pas aborder par la suite: Le tirage au sort pour trancher entre différentes décisions. En dehors du domaine politique, Jon Elster, titulaire de la Chaire de Rationalité et sciences sociales au collège de France qui s’intéresse entre autre aux systèmes de décisions collectives et au tirage au sort donne un exemple intéressant. Dans le cadre de la garde de l’enfant suite à un divorce il propose de l’attribuer, quand les deux parents souhaitent l’obtenir et hors cas extrême, par tirage au sort. Une fois encore l’idée semble à première vue absurde il y a néanmoins au moins deux avantages :
La rapidité de ce mode décision : et donc réduire la période d’instabilité reconnue semble-t-il comme néfaste pour l’enfant.
Eviter au parent qui ne recevra pas la garde l’humiliation d’avoir été jugé comme incompétent.
Mais je ne vais donc pas parler de la prise de décision par tirage au sort mais plutôt du tirage au sort comme mode de choix des représentants.
Quelle est donc l’idée de base : et bien que pour de nombreuses raisons nos dirigeants sont à l’heure actuelle sélectionnés non pas sur leurs capacités à gouverner mais sur leurs capacités à se faire élire. Argument qui semble en effet se vérifier lorsqu’on suit les débats de l’Assemblée nationale sur un sujet dans lequel on a une certaine expertise. Comme certains l’on fait par exemple lors des délibérations autours d’Hadopi. De toute façon il serait tout bonnement impossible d’élire des représentant ayant des expertises en tout.
Dans le système actuel nos représentant sont donc censés acquérir une expertise en se renseignant sur les sujets abordés. On peut considérer que cela est aussi à la portée d’un citoyen normal. Ce point est un élément capital, qui met en valeur une certaine équivalence, mais sûrement pas une raison de changer de système.
Cherchons donc d’autres arguments :
Pour l’élection de dirigeants dans un petit groupe par exemple une association, on pourrait ré évoquer le fait de chercher à éviter le sentiment de frustration et d’humiliation qui accompagne la défaite. Et ainsi empêcher que des questions d’ego nuisent ensuite à l’intérêt collectif. Mais cet argument semble moins valable au niveau de la politique nationale. Même si Nicolas Hulot a semble-t-il abandonné la politique après sa défaite face à Eva Joly a la primaire écologique.
Le tirage sort permet de limiter à priori la professionnalisation et le carriérisme du monde monde politique : or ses partisans considèrent généralement que la professionnalisation encourage ou permet la corruption, l’influence des lobby et la négociation (c’est à dire l’échange de voix de type : je t’échange un vote sur une loi sur la suppression des radars que je trouve plutôt mauvaise contre un vote sur une loi sur les logements HLM que je trouve très importante) . L’idée est aussi qu’il existe une usure du pouvoir et qu’un dirigeant initialement bon ne le restera pas indéfiniment. Par ailleurs les partisans du tirage au sort considèrent que désirer ardemment exercer le pouvoir, ce qui est une caractéristique importante des politiciens professionnels, serait en soit une attitude suspecte. Enfin l’élection amène les politiciens à avoir une logique clientéliste et à soutenir des projets de loi qui maximiseront leur chance d’être réélus plutôt que ceux qui vont dans le sens de l’intérêt collectif.
De manière évidente le tirage au sort réglerait aussi les question de parité ou de représentation des minorités. De même il permettrait d’éviter l’homogénéité des formations (effet science po l’ENA), Dans ce cadre les questions du cumul des mandats et du non renouvellement des mandats ne se posent plus vraiment non plus.
Enfin le processus est beaucoup plus rapide et beaucoup moins coûteux que l’organisation d’une élection… A priori ça semble être un détail mais ce détail peu revêtir une importance capitale car il permet par exemple de renouveler une assemblée tout les six mois de façon à éviter certains travers déjà évoqués. Ou de réunir des assemblées de façon thématique.
Les limites du tirages au sort
J’espère vous avoir convaincu que le système mérite considération. Attardons-nous maintenant sur les défauts.
Le premier généralement évoqué est de tirer au sort des incompétents ou des gens dangereux. Cette crainte me semble justifiée si l’on parle de tirer au sort l’exécutif ce qui me semble de toute façon dangereux et irréaliste. Mais ça ne l’est absolument pas si l’on tire au sort une assemblée. Ou en tout cas çå ne l’est pas plus que la proportionnelle.
Pour écarter le tirage au sort de l’exécutif qui semble défendu par Etienne Chouard j’avancerais un autre contre argument. Souvent un ministre dirige une administration, on peut difficilement imaginer qu’un citoyen tiré au sort puisse avoir de l’autorité sur des hauts fonctionnaires. Diriger le ministère des Affaires étrangères nécessite des compétences particulières. Tirer au sort des citoyens pour exercer ces fonction aboutirait sans doute à laisser le pouvoir à l’administration de ces ministères et mènerait à un système finalement bien peu démocratique.
Il faut aussi remarquer qu’il existe une multitudes de façons d’introduire le tirage au sort en politique. Nico en a d’ailleurs proposé une tout à l’heure qui cumule vote et tirage au sort et qui présente un certain nombre d’avantages comme celui d’inciter les citoyens à ne pas se livrer à des calculs politiques et à exprimer pleinement leur avis.
Attardons-nous maintenant sur le tirage au sort d’une assemblée :
Se pose déjà le problème de la légitimité est-ce qu’un parlement tiré au sort serait perçu comme légitime… A l’heure actuelle, il me semble que la réponse est non néanmoins si cette solution est vraiment la meilleure il est possible d’augmenter la légitime d’un tel système par l’éducation et l’explication de ses avantages.
Je me souviens qu’en école d’ingé on nous expliquait qu’on allait nous apprendre à apprendre et il me semble que si le système actuel ne sélectionne pas nos dirigeants sur leur capacité à gouverner il existe un filtre implicite sur le niveau de diplôme et que ce filtre permet d’avoir une population qui a, par les études, été au moins un peu sélectionné sur sa capacité à apprendre.
Ça reste à prouver, et on n’est pas non plus obligé de penser que ce serait une mauvaise chose, mais il est possible d’imaginer qu’un parlement tiré au sort subirait davantage l’influence des médias.
Ensuite si l’on choisit de mettre en place un tel parlement un certain nombre de problème pratiques se posent :
Doit-il être consultatif, avoir un véto suspensif, avoir tout le pouvoir législatif, le partager avec un parlement élu…
Doit on tirer au sort dans l’ensemble de la population ou parmi des candidats ? – Tirer au sort parmi les volontaires inciterait les partis politiques à maximiser leurs chances en présentant un maximum de candidats tandis que tirer au sort dans l’ensemble de la population risque de sélectionner des parlementaires faiblement motivés.
Si l’on tire au sort parmi l’ensemble de la population faut-il laisser aux gens la possibilité de refuser de participer ?
Si l’on accepte le refus, faut-il, en cas de refus retirer au sort dans l’ensemble de la population ou remplacer un artiste unijambiste protestant de plus de 50 ans par un autre artiste unijambiste protestant de plus de 50 ans ? – La solution semble irréaliste surtout sans fichage de la population tandis que la première introduit un biais
faut-il exclure les prisonniers, les schizophrènes, les personnes possédant un casier judiciaire ?
De quelle taille doit être l’assemblée ? – une assemblée trop grande empêche ses membres de réellement débattre entre eux tandis qu’une assemblée trop petite risque de ne pas être représentative.
D’ailleurs faut-il que ces membres débattent entre eux, leur délibérations doivent-elles être publique ? Leur nom doit-il être communiqué à la population ? Leur vote doit il être anonyme ?
De quelle durée doit être le mandat d’une telle assemblée ? – un mandat trop long risque de réintroduire la négociation et le lobbying tandis qu’un mandat trop court ne laissera pas aux parlementaires le temps nécessaire pour acquérir une expertise sur les sujets sur lesquels ils seront amenés à se prononcer.
Faut-il tirer au sort un unique parlement se prononçant sur tout type de questions ou une assemblée par domaine traité voire par proposition de loi.
Je vais vous laisser méditer sur cette longue liste de question sans y apporter de réponse pour l’instant même si bien sûr j’ai mon avis, et conclurai en affirmant que si le tirage sort présente un certain nombre d’avantages non négligeables, les modalités de sa mise en laissent apparaîtrais des dangers potentiels comparables à ceux de la sélection classique des représentants par le vote.
Vous pouvez aussi regarder les vidéos d’Etienne Chouard qui contiennent des éléments intéressants mais aussi des affirmations gratuites.
Enfin je vous conseille tout particulièrement une note d’une trentaine de pages de Gil Delannoi, un chercheur du Centre de recherches politiques de Sciences Po, pour Fondapol et s’intitulant : le retour du tirage au sort en politique.
Dans la première partie de ce dossier en trois morceaux, Alan a expliqué diverses raisons qui nous amènent à choisir, lors du vote, un camp politique plutôt qu’un autre. Les conclusions laissent à penser que ce choix ne se fait pas en plein libre arbitre. Mais, si notre choix se faisait de manière rationnelle et raisonnable, est-ce que les différentes méthodes d’élections des pays démocratiques permettraient de désigner le choix qui fait le plus l’unanimité, le choix le plus représentatif de l’opinion?
Les “bugs” du système
Si l’on regarde les élections passées, on remarque que la question n’est pas dénuée d’intérêt tant il y eut des “bugs” du système. Par exemple, pour les élections américaines de 2000, Bush l’emporte alors que Al Gore avait recueilli plus de suffrages. Les élections américaines fonctionnaient sur le principe des Grands Électeurs, l’opinion majoritaire du peuple ne s’exprime donc pas toujours. Ou encore, dans l’état de Floride, c’est le futur président qui obtint le meilleur score (serré) en partie “grâce” à des petits candidats qui, bien que n’ayant aucune chance d’accéder au pouvoir suprême, gardaient la possibilité de subtiliser quelques précieuses voix au futur perdant.
Près de nous, en 2002, Jean-Marie Le Pen (JMLP) est qualifié pour le deuxième tour de l’élection présidentielle française pour finalement perdre au second tour contre Jacques Chirac avec un score d’une vingtaine de pourcents. Non je n’ai pas pris la peine d’aller chercher le score exact, ni même je prendrai la peine de citer les sources des sondages dont je parlerai par la suite. Pire encore, ces sondages manquant de citations seront pris comme parole d’évangile! La raison est que ce dossier n’a strictement aucune vocation politique et par conséquent encore moins de propagande. Tous les exemples de scores ne sont ici qu’avec un but didactique et d’exemple, ils ont pour unique vocation d’aider à la compréhension des concepts présentés.
Lors de cette élection donc, conformément au fonctionnement d’un scrutin majoritaire en deux tours, JMLP accède au second tour. Plus de personnes avaient voté pour lui que pour tous les autres candidats à l’exception bien sûr de Jacques Chirac qui obtint le plus de voies lors de ce tour. Cette situation en elle même n’est pas un bug et le fait qu’un candidat ayant des opinions extrêmes accède au second tour d’une élection ne constitue pas en soi une erreur pour un système de vote. En revanche, un grand nombre de sondages réalisés à l’époque à pu mettre en lumière un problème de représentativité du scrutin utilisé par la France pour ses élections au moins depuis l’élection du premier président de la République Napoléon Bonaparte en 1848.
En effet, pour diverses études, tous les seconds tours possibles avec JMLP furent testés lors de sondages auprès des Français. Il s’avère que le résultat de ces sondages fut éloquent : le président du Front National ne gagnait sous ces hypothèses aucun second tour! Pourtant, c’est bien ce candidat n’ayant aucune chance de gagner l’élection présidentielle qui fut sélectionné pour le référendum final. Plus déroutant encore, selon certains sondages, si le second tour avait été entre Jacques Chirac et Lionel Jospin (troisième à l’époque), ce dernier aurait gagné. Non content de sélectionner un candidat n’ayant aucune chance de gagner, le vainqueur sélectionné par ce système de vote lors du deuxième tour dépend fortement des résultats des autres candidats lors du premier tour! Ce paradoxe selon lequel le résultat de l’élection dépend du score des “petits” candidats s’appelle le paradoxe d’Arrow.
Toujours une majorité de mécontents
Ces exemples illustrent l’incapacité de systèmes vieux comme certaines démocraties de représenter au mieux l’opinion des candidats. Mais évitons de taper trop vite sur nos institutions, car depuis 1785 (donc 4 ans avant la Révolution française et l’instauration d’une “démocratie”, l’honneur est sauf), on sait qu’il existe des situations où l’unanimité n’existe pas. Un esprit moqueur dirait que ces situations sont gravées dans l’ADN des Français : dans ces cas, quel que soit le candidat vainqueur il y aura une majorité de mécontents!
En effet, Nicolas de Condorcet explique dans son “Essai sur l’application de l’analyse à la probabilité des décisions rendues à la pluralité des voix” qu’à partir de trois candidats P, F et C, on peut tout à fait se retrouver dans des cas où :
Une majorité de personnes préfèrent P à C
Une majorité de personnes préfèrent C à F
Une majorité de personnes préfèrent F à P
Dans les “relations d’ordre” au sens mathématique (comme le “plus petit ou égal” entre deux nombres), ce genre de situation ne peut pas arriver, car l’une des propriétés respectées est la transitivité. À savoir justement que les deux premières conditions ci-dessus impliquent le non-respect de la troisième. Mais dans certains systèmes comme le vote majoritaire ou le jeu Pierre, Feuille, Ciseaux, la transitivité n’est pas respectée :
La Pierre écrase les Ciseaux
Les Ciseaux coupent la Feuille
La Feuille cache la Pierre
Il est à noter que si ce jeu respectait la transitivité, il perdrait pas mal d’intérêt (on pourrait choisir l’objet qui les bat tous). Le fait de ne pas pouvoir obtenir dans tous les cas un candidat qui fait l’unanimité pourrait justifier l’existence du besoin d’un choix “politique” (comprendre imparfait et donc subjectif, mais il n’existe pas mieux). Heureusement, dans la pratique, cette situation est plutôt rare et il existe généralement un “vainqueur de Condorcet“, candidat qui fait l’unanimité dans tous les seconds tours. En 2007 par exemple, selon les sondages, François Bayrou était un vainqueur de Condorcet : il était donné gagnant de tous les seconds tours possibles. Mais encore une fois, ce bon vieux scrutin majoritaire ne permettait même pas de lui faire atteindre le deuxième tour…
La télé-réalité au pays des merveilles
Devant ces deux paradoxes, on est en droit de se demander s’il ne serait pas nécessaire de réformer le système de vote, mais encore faut-il en choisir un nouveau. Tout au long de l’histoire et encore aujourd’hui de nombreuses personnes ont proposé des systèmes de vote variés. Parmi eux, le révérant Charles Ludwidge Dogson, professeur de mathématiques d’une église chrétienne a écrit un pamphlet sur les systèmes d’élections. Vous connaissez peut-être ce mathématicien sous son pseudonyme qu’il utilisait pour raconter des histoires de lapin perdu dans un jeu de cartes, mais ne manquant pas le temps de prendre un thé : Lewis Carroll!
Dans son écrit, il présente diverses méthodes de côté et leur défaut. En voici quelques-unes, une manière comme une autre de montrer que notre méthode actuelle n’est ni la plus naturelle, ni la plus facile, ni la plus convaincante (il se peut que j’ai un peu modifié le nom des méthodes par rapport à l’original, n’hésitez pas à consulter le livre cité en référence pour y trouver les vrais noms) :
La méthode “Tout le monde veut prendre sa place” : on effectue un vote avec deux candidats pris au hasard parmi tous, celui qui perd est éliminé et celui qui gagne dispute un nouveau match avec un des candidats restants. Et ainsi de suite jusqu’à ce qu’il n’y ait plus de candidat;
La méthode “Secret Story” : on vote pour chaque candidat, celui qui obtient le moins de votes est éliminé et on recommence jusqu’à ce qu’il ne reste plus qu’un seul candidat;
La méthode “Eurovision” : chaque électeur a un nombre de points à distribuer entre les candidats. Le vainqueur est celui qui a le plus de points.
Comme l’indiquent les noms, toutes ces méthodes ont déjà été mises en pratiques (en fait toutes celles du pamphlet l’ont été). De la télé-réalité au sport en passant bien évidemment par la politique, nous regorgeons de méthodes diverses et variées pour sélectionner un ou plusieurs “vainqueurs”. Mais le scrutin majoritaire à deux tours est utilisé avec tous ses défauts connus depuis plus de 150 ans et ce n’est pas près de changer! Remarquez pourtant qu’avec tous ces systèmes, toujours selon les sondages de 2002, JMLP n’aurait pas passé les premières étapes.
Représenter le peuple
Pour déterminer les meilleurs modèles de scrutins, il fallut poser des règles que respecteraient tous les scrutins. Par exemple, les règles les plus simples demandées sont en général :
Neutralité : que tous les candidats soient traités à égalité par le système de vote;
Démocratie : que tous les votants soient égaux devant le système de vote. Un exemple de système de “vote” qui ne respecte pas la démocratie est le système “dictatorial” où un seul électeur bien défini décide tout seul de l’issue du vote (notez que la définition est un peu différente de celle d’un dictateur “classique”).
Résolution : que le système donne un unique vainqueur dans tous les cas;
auquel on ajoute pour limiter le grand n’importe quoi :
Pareto : dans tous les cas de duels (un candidat contre un autre) concernant le vainqueur, au moins un électeur a voté pour le vainqueur. Un système qui ne respecte pas le Pareto est donc un système où il existe un candidat contre lequel le vainqueur n’obtient aucun vote.
Du fait du paradoxe de Condorcet, le scrutin majoritaire ne peut respecter ces trois hypothèses (un candidat peut tout à fait être élu alors qu’il n’obtiendrait strictement aucun vote dans un cas de duel avec un petit candidat). De même, le système “tout le monde veut prendre sa place” ne respecte pas le principe de neutralité (l’ordre des duels a une énorme importance). La méthode de l’eurovision n’assure pas enfin que l’on ait un unique vainqueur, car il peut y avoir des cas d’égalité.
Grâce à ces trois petites hypothèses sur le système de vote, on peut alors formuler le théorème suivant (trouvé, sous un autre nom bien sur, dans le livre de Taylor cité en annexe, sans plus de précision, je suppose qu’il en est l’auteur) :
Théorème de Secret Story
Si le nombre d’électeurs est un multiple d’un nombre compris entre 2 et le nombre de candidats, alors toute méthode de scrutin démocratique, neutre et Pareto ne peut sélectionner un unique candidat.
Dans le cas contraire, si le nombre d’électeurs n’est pas un multiple d’un nombre compris entre 2 et le nombre de candidats, la méthode “Secret Story” est une méthode démocratique, neutre et Pareto qui désigne un unique candidat.
Sans faire la démonstration complète de ce théorème, on peut facilement comprendre l’hypothèse étrange sur le nombre de votants. Imaginons une élection à 4 candidats A, B, C et Cheminade et qu’il y ait 3000 électeurs (3000 est un multiple de 3 qui est bien inférieur au nombre de candidats). Imaginons alors que les électeurs se répartissent en trois groupes :
1000 électeurs classent les candidats dans l’ordre A-B-C-Cheminade
1000 électeurs classent les candidats dans l’ordre B-A-C-Cheminade
1000 électeurs classent les candidats dans l’ordre C-B-A-Cheminade
Le système de vote étant Pareto, on sait que le vainqueur doit être parmi A, B ou C. Or d’après les principes démocratie et de neutralité, nécessairement les trois vainqueurs potentiels sont soit tous choisis à égalité soit tous éliminés. Dans tous les cas on ne peut jamais choisir un seul candidat!
Ce théorème montre un premier avantage d’un autre système de vote qui n’est pourtant pas bien compliqué; c’est celui utilisé dans pratiquement toutes les émissions de télé-réalité! Et si l’idée de faire autant de tours que de candidats vous rebute, sachez qu’il existe des formulations de ce vote en un seul tour en demandant à chaque électeur de classer tous les candidats par ordre de préférence.
La magouilleuse électorale
Depuis 2002 et la venue de JMLP au second tour est apparue la notion de “vote utile“. Il s’agit de ne pas voter selon ses convictions profondes, mais de voter pour le candidat qui aura le plus de chances d’être élu afin d’avoir un résultat final qui nous déplaise moins. Lors de cette élection, il s’agissait de voter Jospin pour lui permettre d’être au deuxième tour contrairement aux habitudes des Français de voter pour un “petit” candidat au premier tour. L’auteur d’Alice au pays des merveilles résume très bien cela par la formule :
“[voters] adopt a principle of voting which makes it more of a game of skill than a real test of the wishes of the electors” (les électeurs votent plus comme s’ils participaient à un test de compétences qu’à l’expression de leur opinion).
En effet, tous les systèmes de votes présentés depuis le début sont sensibles à la “manipulation” (dans un sens un peu différent du sens usuel). C’est-à-dire qu’un électeur qui sait ce que vont voter les autres va pouvoir modifier le résultat de l’élection en modifiant son vote (que ce soit le chiffre du pourcentage ou même le vainqueur). Il s’est alors posé la question de savoir s’il existe un système d’élection robuste à la manipulation, c’est à dire où chaque électeur n’a aucun intérêt à voter autrement que sincèrement. La réponse à cette question à été apportée en 1973 par les deux Américains Gibbard et Satterthwaite. Ils ont démontré que dès qu’il y a au moins trois candidats, la seule méthode robuste à la manipulation est le système dictatorial! En revanche, on peut montrer qu’à deux candidats seulement, le scrutin majoritaire est le seul robuste à la manipulation. C’est ici tout le paradoxe du système de vote français, le premier tour est l’un des pires systèmes que l’on puisse trouver alors que le second tour est le seul système robuste à la manipulation qui existe. Donc, le seul système de vote où chacun a intérêt à voter selon ses idées est le système dans lequel un seul électeur décide du résultat de l’élection. Et surtout, ils ont donc montré qu’il n’existe pas de méthode démocratique robuste à la manipulation… À moins qu’on arrive à transformer un système dictatorial en système démocratique. Grâce aux mathématiques, c’est possible et cela s’appelle les scrutins stochocratiques!
De la dictature à la démocratie avec un dé
Les scrutins stochocratiques incluent de l’aléatoire dans le vote : le résultat peut être différent avec exactement les mêmes bulletins mis dans l’urne. Un exemple simple de scrutin stochocratique bâti sur le scrutin majoritaire à un tour :
on demande à chaque électeur de choisir son candidat préféré;
on rassemble tous les bulletins dans une urne
on en tire un au hasard : c’est cet unique bulletin qui détermine le vainqueur.
Alors deux solutions vis-à-vis de la manipulation pour un électeur :
Soit son bulletin détermine le vainqueur : alors il n’a aucun intérêt à ne pas voter selon ses convictions vu que c’est lui qui décide de l’issue;
Soit son bulletin ne détermine pas le vainqueur : alors son vote ne sert à rien donc il ne peut pas manipuler le scrutin.
Bien entendu, ce scrutin pose plusieurs problèmes autant dans la réalisation que dans les cas de malchance comme David va vous l’expliquer. Plus généralement, le fait de ne pas avoir de résultats scientifiques sur le meilleur système de vote théorique justifie l’existence des choix politiques : sans meilleur système démontré, il faut malgré tout en choisir un par des arguments qui sont du coup plus politiques que scientifiques.
Pour plus de détails, en savoir plus, n’hésitez pas à consulter les sources suivantes :
“Social Choice and the Mathematics of Manipulation” par Alan D. Taylor : Attention livre avec des math, des vrais, des durs. Ca veut pas dire qu’il est impossible à lire mais il vaut mieux avoir l’habitude de publications mathématiques et avoir le temps de s’y plonger. A défaut, je ne saurait trop vous conseiller de vous rabattre sur l’excellent article d’Images des mathématiques proposant un résumé.
“Ne votez pas, jugez!” dans Pour la Science n°414 : Beaucoup plus accessible que le précédent mais aussi moins complet, cet article présente entre autre un nouveau système de vote visant à minimiser la manipulation (mais sans l’annuler), le jugement majoritaire
Ce livre explore les mécanismes fascinants de la croyance chez l’être humain et s’appuie sur des centaines de travaux scientifiques; c’est un vrai bijou de vulgarisation. Un des chapitres est consacré à la question des croyances derrière les affiliations politiques et c’est ce que nous allons explorer ensemble maintenant.
Michael Shermer ne parle pas exactement de gauche et de droite mais de libéralisme et de conservatisme. Etats-Unis obligent. C’est sans doute un peu simpliste de transposer 1:1 libéral=gauche et conservateur=droite car certaines nuances devraient quand même être prises en considération (en Europe, quand on est de droite, on ne se balade pas forcément avec une arme à feu et on ne passe pas nécessairement ses dimanches à l’église, mais bon, selon les chercheurs cités plus loin, ce découpage tient quand même la route).
Le chapitre sur les croyances en politique commence par une série de stéréotypes pour poser le décor (genre: si vous êtes libéral, vous lisez le New-York Times, vous détestez George W. Bush et Sarah Palin, vous reconnaissez le rôle de l’homme dans le réchauffement climatique, vous êtes pour la redistribution des richesses par les impôts etc. Si vous êtes conservateur, vous êtes anti-avortement, pro-peine de mort, vous êtes climato-sceptique et vous souhaitez moins d’intervention de l’Etat) puis l’auteur pose très rapidement un premier avertissement: les universitaires américains sont essentiellement libéraux, donc de gauche, et la plupart des études sur cette question-là sont biaisées. Certaines études vont jusqu’à poser le problème de la manière suivante “le conservatisme politique est-il une forme atténuée de folie?” Tout comme la recherche sur le cancer vise à éradiquer la maladie, il semble que les études sur le conservatisme politique cherchent à corriger une tare et évidemment, l’approche n’est pas défendable.
Jonathan Haidt, psychologue à l’Université de Virginie a remarqué ce biais et l’a dénoncé dans article intitulé “What Makes People Vote Republican?” (Qu’est-ce qui pousse les gens à voter républicain?). L’interprétation libérale typique, qu’on retrouve dans de nombreuses études voudrait que les gens votent républicain car ils seraient psycho-rigides, amoureux de la hiérarchie et terrorisés par l’incertitude, le changement et la mort. Haidt justement a invité ses collègues à sortir de ces pseudo-diagnostics, à prendre un peu de distance épistémologique. Et en cherchant un peu, il a trouvé des études moins biaisées qui amènent des éléments de réponse:
Par exemple, dans leur livre “Partisan Hearts and Minds” (Coeurs et esprits partisans), les politologues Donald Green, Bradley Palmquist, et Eric Schickler ont montré que la plupart des gens ne choisissent pas un parti politique parce que celui-ci reflète leur opinion, mais parce qu’ils s’identifient d’abord avec une position politique (en général héritée de leurs parents, de leurs groupes de pairs ou de leur éducation). Une fois qu’ils ont choisi cet engagement politique à travers le parti approprié, les sympathisants en adoptent le discours et les vues.
Selon Shermer, cela montre la nature profondément tribale de la politique moderne et des stéréotypes véhiculés par chaque tribu.
Tribu?
Pas besoin d’être anthropologue pour comprendre que, selon les libéraux, les républicains sont une bande de chauffeurs de 4×4 qui mangent trop de viande, trimballent des armes, veulent réduire le rôle de l’Etat, supprimer les impôts, imposer la bible, etc. A l’inverse, les conservateurs pensent que les libéraux sont une bande de conducteurs de véhicules hybrides qui mangent du tofu, embrassent les arbres, portent des sandales et sauvent les baleines.
J’aime bien partir de l’exemple américain car les stéréotypes sont si caricaturaux que cela rend la démonstration plus évidente. Et ces stéréotypes sont tellement présents que tout le monde les comprend. Commentateurs politiques et comédiens s’appuient dessus sans problèmes. Il y a du vrai, bien sûr, dans ces stéréotypes qui reflètent des valeurs morales différentes, des valeurs morales que Shermer qualifie “d’intuitives”.
En fait, de nombreuses recherches démontrent désormais que la plupart de nos décisions morales émanent de sentiments moraux automatiques plutôt que de calculs rationnels. Face aux questions morales, on ne réfléchit pas de manière rationnelle en pesant le pour et le contre de chaque argument et en examinant les preuves qui le sous-tendent, par exemple. Non, on décide de manière intuitive et on rationalise après. C’est-à-dire: on décide d’abord et on construit ensuite un discours pour justifier sa décision, à ses propres yeux et aux yeux des autres. C’est un processus plus émotionnel que rationnel. Exactement comme pour la plupart des croyances que nous avons.
Pour mieux comprendre ces stéréotypes et le processus d’adhésion à un camp plutôt qu’à l’autre, il faut s’appuyer sur ce que Jonathan Haidt appelle la théorie de l’intuition morale. Cette théorie explique par exemple pourquoi nous éprouvons tous une aversion naturelle à certains comportements, comme l’inceste par exemple. Même si nous sommes incapables d’articuler la moindre explication rationnelle pour justifier cette aversion dans certains cas. Par exemple, écoutez bien le scénario suivant et essayez de décider si les actions des personnages sont moralement acceptables ou pas:
Charles et Julie sont de jeunes adultes frère et soeur. Pendant leurs vacances d’été, ils se retrouvent un soir seuls dans une maison de vacances près d’une plage. Ils décident que ce serait intéressant et amusant d’essayer de faire l’amour. En tout cas, ce serait une nouvelle expérience pour chacun d’eux. Julie prend la pilule mais Charles utilise quand même un préservatif, juste pour être sûr. Ils aiment beaucoup l’expérience, tous les deux, mais décident ne pas recommencer. Ils décident aussi de garder secrète cette expérience, ce qui les rend plus proches encore l’un de l’autre. Qu’en pensez-vous? Etait-ce OK qu’ils fassent l’amour?
Pratiquement toutes les personnes qui lisent cette vignette, construite de toutes pièces par Jonathan Haidt pour tester les intuitions morales, considèrent que c’est moralement faux. Et quand on leur demande pourquoi, elles donnent des réponses telles que “Julie pourrait tomber enceinte”, ce qui est bien sûr impossible avec la pilule et le préservatif, ou encore “ça va nuire à leur relation” (mais on voit que ce n’est pas le cas) ou “ça pourrait se savoir” (alors que la vignette indique bien qu’ils ne révèlent pas l’information). Finalement, les participants cessent de raisonner et avouent simplement “Je ne sais pas. Je ne peux l’expliquer. Je sais juste que c’est faux.” Cet exemple et de nombreuses recherches qui conduisent à des résultats similaires ont amené Haidt à conclure que l’évolution nous a dotés d’émotions morales pour nous permettre de survivre et de nous reproduire. Chez nos ancêtres du paléolithique, l’inceste conduisait à des mutations génétiques aux conséquentes très graves. A l’époque, évidemment, personne ne se doutait du mécanisme génétique sous-jacent mais le tabou de l’inceste a “évolué” et empêché nos ancêtres d’avoir des relations sexuelles avec leurs proches, en favorisant la survie des descendants de ceux qui allaient chercher leur tendre moitié hors de la famille. Haidt, en se basant sur de nombreuses approches (anthropologie sociale, psychologie sociale, psychologie évolutive, philosophie) propose que les fondements de notre sens du juste et du faux s’appuient sur 5 systèmes psychologiques innés et universels. Et on va revenir à notre problématique gauche/droite car ces tendances politiques s’inscrivent clairement dans ces systèmes psychologiques:
Protection face au mal. (Traduction un peu minable de “Harm/care”, mais je n’ai pas mieux à proposer, sorry). Soit notre capacité de mammifères sociaux à “ressentir” la douleur de l’autre. Nous avons développé un sens de l’empathie et de la sympathie avec notre capacité de nous mettre à la place de l’autre et d’imaginer sa souffrance et son réconfort. Ce premier système est à la base de vertus morales telles que la générosité, la gentillesse et le soutien affectif.
Justice et réciprocité. Système basé sur le processus évolutif d’altruisme réciproque (je te gratte le dos si tu me grattes le dos), cela a finalement donné des sentiments authentiques d’échanges justes ou faux, ou plutôt justes ou injustes; la fondation même des idéaux politiques de justice, des droits et de l’autonomie individuelle.
Loyauté de groupe. Système basé sur notre longue histoire d’espèce tribale capable de former des coalitions sans cesse remises en question. Nous avons développé une propension à créer des amitiés au sein du groupe et des inimitiés à l’égard des membres d’autres groupes. Ce système crée un effet “bande de frères” au sein d’un groupe et sous-tend les notions de patriotisme et de sacrifice au nom du groupe.
Autorité/respect. Cela est dû à notre longue histoire de primates et d’interactions sociales hiérarchisées. Nous avons développé une tendance naturelle à respecter l’autorité et faire preuve de déférence à l’égard des leaders et des experts. Nous suivons les règles édictées par ceux qui se trouvent au-dessus de nous dans la hiérarchie sociale. Ce système moral est à l’origine de la capacité de diriger ou de suivre, ainsi que de l’estime pour les autorités légitimes et le respect des traditions.
Pureté/sacré. Les contours de ce fondement moral-ci sont dessinés par la psychologie du dégoût et de la contamination. Nos émotions ont évolué d’une manière qui nous attire vers le propre et nous éloigne du sale. C’est ce qu’on trouve derrière les religions qui poussent vers des idéaux moins charnels et plus élevés. C’est le fondement aussi de l’idée que le corps est sacré et sans cesse menacé par des activités immorales et autres contaminations (que l’on retrouve dans l’engouement pour le bio par exemple.)
Année après année, à l’Université de Virginie, Jonathan Haidt et son collègue Jesse Graham, ont étudié les opinions morales de plus de 118’000 personnes dans une douzaine de pays de toutes les régions du monde et ils ont trouvé cette différence systématique entre les libéraux et conservateurs et par extension, dans d’autres cultures, entre les sympathisants de gauche et de droite:
À gauche, on a de meilleurs scores qu’à droite sur les systèmes 1 et 2 (protection face au mal et justice/réciprocité), mais, à gauche toujours, on est moins bon qu’à droite sur les valeurs 3, 4 et 5 (loyauté de groupe, autorité/respect, pureté/sacré). A droite, on est à-peu-près au même niveau sur chacun des 5 systèmes mais moins bons qu’à gauche sur 1 et 2 et meilleurs qu’à gauche sur 3, 4 et 5. Vous pouvez vous tester vous-mêmes sur le site http://www.yourmorals.org. (Page “Explore Your Morals”, 1er lien du 2e tableau: “Moral Foundations Questionnaire”)
En d’autres termes, la gauche ou les progressistes questionnent l’autorité, célèbrent la diversité et mettent leurs croyances et leurs traditions à s’occuper des faibles et des opprimés. Ils cherchent le changement et la justice quitte à risquer le chaos politique et économique.
Par contraste, la droite ou les conservateurs mettent l’accent sur les institutions et les traditions, la foi et la famille, la nation et la religion. Ils veulent de l’ordre pour le plus grand nombre, quitte à ce que les plus faibles passent à travers les mailles du filet.
Bien sûr, il y a des exceptions à de telles généralités mais l’idée à retenir, c’est qu’au lieu de voir la gauche et la droite en termes de juste et de faux ou vice-versa – suivant de quel côté on se situe – il s’agit de reconnaître que libéraux et conservateurs mettent l’accent sur des valeurs morales différentes, mais tout aussi valides et indispensables les unes que les autres.
Au lieu d’opposer la gauche et la droite comme nous le faisons dans les démocraties occidentales, n’aurait-on pas meilleur temps, comme le suggère Jonathan Haidt dans une vidéo TED en bonus à la fin du dossier, de reconnaître que les deux sont l’expression de certains traits moraux et que l’une sans l’autre n’a aucun sens? Et que l’une contre l’autre n’est qu’une perte d’énergie et de temps? Les religions orientales l’ont compris depuis longtemps. La gauche et la droite pourraient se marier et se compléter comme s’unissent et se complètent le yin et le yang, comme Vishnu et Shiva dans l’hindouisme, ou comme le disait le maître bouddhiste Maître Sengcan (VIe s. avjc [update: merci à François Burnot pour le rectificatif. Maître Sengcan a vécu aux VI-VIIe s. de notre ère. Il serait mort en 606]) :
Si vous voulez que la vérité se révèle à vous, ne soyez jamais pour ou contre. La lutte entre “pour” et “contre” est la pire maladie de l’esprit
Et pour ne pas rafler la vedette à Marco en finissant sur une quote (même pas en anglais), je ne terminerai pas là-dessus.
Encore deux mots… Pour indiquer que cette théorie de l’intuition morale, de Jonathan Haidt et collègues est une théorie prometteuse et bien accueillie mais encore jeune et en constante évolution. De peur d’avoir négligé des systèmes moraux importants, les auteurs ont ouvert un concours (maintenant terminé) invitant d’autres chercheurs à critiquer le modèle et à l’améliorer. Ils ont reçu de nombreuses contributions dont certaines tenaient la route et ils ont versé en février dernier un chèque de 500 $ à chacun des 3 contributeurs lauréats, psychologues et ethnologues de prestigieuses universités américaines qui ont proposé d’ajouter au modèle :
un système: “liberté/oppression”
un système “gaspillage”, notamment pour l’aversion au gaspillage de nourriture
un système “propriété/possession”
Ces trois systèmes sont en train d’être testés et en cas de succès seront ajoutés au modèle décrit dans ce dossier.
La vidéo bonus de Jonathan Haidt filmée en mars 2008 dans une conférence TED:
Quelques ressources sur la psychologie morale:
La page “Moral Psychology” sur Wikipédia (malheureusement en anglais seulement)
He is back!! Et oui revoilà Mathieu! Près de 5 mois ont passé depuis son dernier dossier, et il revient en Guest-star nous présenter un sujet sur les algorithmes de recommandation. Vous allez enfin savoir comment fonctionnent les applications en ligne pour nous suggérer des produits correspondant à nos goûts.
Il existe des centaines d’algorithmes qui ont été utilisés pour l’implémentation de systèmes de recommandation. La plupart relève de concepts mathématiques avancés. Dans ce dossier, on va tenter d’analyser différentes approches et stratégies utilisées lors de la mise en place d’un système de recommandation.
Wikipedia définit un système de recommandation comme une forme spécifique de filtrage de l’information visant à présenter les éléments d’information (films, musique, livres, news, images, pages Web, etc) qui sont susceptibles d’intéresser l’utilisateur.
Dit autrement, un système de recommandation cherche à prédire la valorisation ou préférence qu’un utilisateur attribuerait à un objet (livre, musique, film…) ou à un élément social (personne, groupe, communauté) qu’il n’avait pas encore considéré.
Un système de recommandation requiert généralement 3 étapes:
La première consiste à recueillir de l’information sur l’utilisateur.
La deuxième consiste à bâtir une matrice ou un modèle utilisateur contenant l’information recueillie.
La troisième consiste à extraire à partir de cette matrice une liste de recommandations.
Collecte d’Information
Pour être pertinent, un système de recommandation doit pouvoir faire des prédictions sur les intérêts des utilisateurs. Il faut donc pouvoir collecter un certain nombre de données sur ceux-ci afin d’être capable de construire un profil pour chaque utilisateur.
Une distinction peut être faite entre 2 formes de collecte de données:
Collecte de données explicite – Filtrage actif: repose sur le fait que l’utilisateur indique explicitement au système ses intérêts.
Exemple: demander à un utilisateur de commenter, taguer/étiqueter, noter, liker ou encore ajouter comme favoris des contenus (objets, articles…) qui l’intéressent. On utilise souvent une échelle de ratings allant de 1 étoile (je n’aime pas du tout) à 5 étoiles (j’aime beaucoup) qui sont ensuite transformées en valeurs numériques afin de pouvoir être utilisées par les algorithmes de recommandation.
Avantage: capacité à reconstruire l’historique d’un individu et capacité à éviter d’agréger une information qui ne correspond pas à cet unique utilisateur (plusieurs personnes sur un même poste).
Inconvénient: les informations recueillies peuvent contenir un biais dit de déclaration.
Collecte de données implicite – Filtrage passif: repose sur une observation et une analyse des comportements de l’utilisateur effectuées de façon implicite dans l’application qui embarque le système de recommandation, le tout se fait en “arrière-plan” (en gros sans rien demander à l’utilisateur).
Exemples:
Obtenir la liste des éléments que l’utilisateur a écoutés, regardés ou achetés en ligne.
Analyser la fréquence de consultation d’un contenu par un utilisateur, le temps passé sur une page.
Monitorer le comportement en ligne de l’utilisateur.
Analyser son réseau social.
Avantage: Aucune information n’est demandée aux utilisateurs, toutes les informations sont collectées automatiquement. Les données récupérées sont a priori justes et ne contiennent pas de biais de déclaration.
Inconvénient: Les données récupérées sont plus difficilement attribuables à un utilisateur et peuvent donc contenir des biais d’attribution (utilisation commune d’un même compte par plusieurs utilisateurs). Un utilisateur peut ne pas aimer certains livres qu’il a acheté, ou il peut l’avoir acheté pour quelqu’un d’autre.
Modèle Utilisateur
Le modèle utilisateur se présente généralement sous forme de matrice. On peut se le représenter comme un tableau qui contient des données recueillies sur l’utilisateur associées aux produits disponibles sur le site web.
Un autre point important est comment le temps influence le profil de l’utilisateur. Les intérêts des utilisateurs, généralement, évoluent au cours du temps. Les données du modèle utilisateurs devraient donc constamment être réajustées pour rester conformes aux nouveaux centre d’intérêts de l’utilisateur.
Liste de recommandations
Pour extraire une liste de suggestions à partir d’un modèle utilisateur, les algorithmes utilisent la notion de mesure de similarité entre objets ou personnes décrits par le modèle utilisateur. La similarité a pour but de donner une valeur ou un nombre (au sens mathématique du terme) à la ressemblance entre 2 choses. Plus la ressemblance est forte, plus la valeur de la similarité sera grande. A l’inverse, plus la ressemblance est faible, et plus la valeur de la similarité sera petite. On verra plus tard dans le dossier quelques exemples.
Types de système de recommandation
On a l’habitude de présenter 4 approches possibles pour un système de recommandation:
Il s’agit de recommander des objets sur la base du comportement passé de l’utilisateur.
Exemples:
Des produits achetés ou sélectionnés sur un site de e-commerce, ainsi qu’un certain nombre d’actions ou décisions effectuées par l’utilisateur qui permettent de prédire de nouveaux produits susceptibles de l’intéresser.
Les annonces publicitaires (par ex. Adsense de Google) sont considérées comme des systèmes de recommandation personnalisée qui se basent sur le comportement passé de l’utilisateur (navigation, clics, historique de recherche…)
Recommandation Objet
Il s’agit de recommander des objets (ou contenus) en se basant sur les qualités et propriétés intrinsèques de l’objet lui-même et en les corrélant avec les préférences et intérêts de l’utilisateur. Ce type de système va donc extraire un certain nombre de caractéristiques et attributs propres à un contenu, afin de pouvoir recommander à l’utilisateur des contenus additionnels possédant des propriétés similaires. Cette méthode crée un profil pour chaque objet ou contenu, c’est-à-dire un ensemble d’attributs/propriétés qui caractérisent l’objet.
Exemples:
La décision de sélection et recommandation ou non d’un document à un utilisateur peut se baser sur le contenu (les mots présents) dans celui-ci, c’est-à-dire sur une comparaison des thèmes abordés dans le document par rapport aux thèmes qui intéressent l’utilisateur.
Pour décider la suggestion d’un article (news) ou non, un système de recommandation peut se baser sur les mot-clés principaux de l’article et les comparer avec les mot-clés apparaissant dans d’autres articles que l’utilisateur a évalués positivement dans le passé.
Dans le cas d’un site de vente de livre en ligne, on va se baser sur les caractéristiques du livre pour effectuer des recommandations, comme par exemple le sujet que traite l’ouvrage, son genre, son auteur, l’éditeur, etc. On pourrait ainsi recommander le livre Harry Potter à un utilisateur, si on sait d’une part que ce livre est un roman fantastique et d’autre part que l’utilisateur aime les romans fantastiques. Un système de recommandation pourra donc accomplir cette tâche seulement s’il a à disposition 2 types d’information: 1) la description des caractéristiques du livre et 2) un profil utilisateur qui décrit les intérêts (passés) de celui-ci en termes de préférence de type de livre. La tâche de recommandation consiste donc à déterminer les livres qui correspondent le mieux aux préférences de l’utilisateur.
Profil des livres
Profil/Préférences Utilisateur
Les algorithmes de recommandation objet permettent de développer des modèles afin de trouver des patterns ou motifs semblables entre différentes données. Ils évaluent à quel point un contenu pas encore vu par l’utilisateur est similaire aux contenus que celui-ci a évalués positivement dans le passé. Pour ce faire, on utilise la notion de similarité qui peut être mesurée de plusieurs manières:
Le système peut tout simplement vérifier si le livre se trouve dans la liste des genres préférés de l’utilisateur. Dans ce cas la similarité sera de 0 ou 1 (binaire/boolean).
Une autre façon serait de ne pas se baser sur le genre du livre, mais sur les mot-clés qui caractérisent l’ouvrage, et calculer la similarité de chevauchement entre les mots-clés du livre qui va éventuellement être suggéré avec les mots-clés préférés de l’utilisateur. Un des indicateurs de mesure de similarité qu’on utilise dans le cas d’un objet avec des propriétés multi-valeurs (cas des mot-clés) est le coefficient de Dice. Si chaque livre est décrit par un ensemble de mot-clés, le coefficient de Dice permet de mesurer le degré de similarité entre 2 livres à partir de leurs mot-clés.
Dans le cas de documents de texte, on peut également imaginer que le contenu de chaque document soit décrit à partir d’une liste de tous les mots apparaissant dans le document, et décrire chaque document par un vecteur de valeurs binaires/booléennes, où un 1 indiquerait que le mot apparaît dans le document et un 0 indiquerait que le mot n’apparaît pas dans le document. Si le profil utilisateur est décrit par une liste similaire (un 1 indique un intérêt pour un mot-clé), on peut facilement associer et proposer des documents en mesurant le chevauchement entre les mot-clés qui intéressent l’utilisateur et les mots contenus dans le document. Le problème qui surgit avec une telle approche est qu’on assume que chaque mot a la même importance au sein d’un document. Or unmot qui apparaît très souvent ne caractérise pas forcément mieux un document. En plus, un plus large chevauchement entre les préférences de l’utilisateur et un document apparaîtera naturellement plus le document est long. En conséquence, le système de recommandation tendera à proposer des longs documents. Pour résoudre ces problèmes, on applique des techniques qui permettent de réduire le poids des mots qui apparaissent très souvent et d’augmenter le poids de ceux qui apparaissent plus rarement. Pour rendre encore plus compacte la liste des mots présents dans un document, on peut aussi quitter un certain nombre de mots qui sont sans intérêt, comme les prépositions, les articles… En normalisant aussi différentes variantes d’un même mot, par exemple les verbes conjugués sont remplacés par leur infinitif (volait par voler). On peut aussi décider de limiter la liste aux n mots les plus pertinents apparaissant dans les documents. Différents travaux ont montrés que le nombre optimum de mots à prendre en compte se trouve aux alentours de 100. Si trop peu de mots sont sélectionnées (moins de 50), on voit que d’importantes caractéristiques d’un document ne sont pas couvertes. Et si trop de mots sont inclus, certains ont peu d’importance et apportent plus de bruit qu’autre chose, ce qui réduit la qualité de la recommandation. On utilise aussi des base de connaissances lexicales externes pour éliminer des mots non pertinents.
De façon générale, les algorithmes de recommandation objet assignent un poids plus ou moins élevé aux attributs d’un contenu selon l’importance de ceux-ci. Le poids exprime donc l’importance de chaque attribut pour un utilisateur.
Un autre algorithme de recommandation objet couramment utilisé est la méthode de retour de pertinence de Rocchio (Rocchio’s relevance feedback) ou classification de Rocchio. L’idée de cette méthode est de prendre en compte le point de vue des utilisateurs sur les recommandations proposées. Le principe, simple, repose sur le fait que l’utilisateur est le seul à savoir exactement ce qu’il recherche et apprécie, il est donc le plus à même de juger de la pertinence des suggestions retournées par un système de recommandation. Partant de cette idée, les systèmes exploitant le retour de pertinence permettent de récupérer ces « jugements » utilisateurs et les exploitent pour améliorer et affiner les recommandations. Techniquement, l’idée est dans un premier temps de décomposer les contenus évalués par l’utilisateur en 2 groupes (vecteurs, clusters) D+ (contenus évalués positivement et pertinents) et D- (contenus évalués négativement et non pertinents). Par un procédé mathématique on calcule une moyenne (prototype) qui permet de déterminer le centre (centroid) de chacun des 2 groupes (vecteurs) D+ et D-. Lorsqu’un nouvelle requête est effectuée par l’utilisateur, les résultats à recommander sont pondérés en fonction des 2 groupes D+ et D-. C’est-à-dire, on ajoute au résutats de la requête la liste D+ et on soustrait (retire) la liste D-, le tout de façon pondérée. L’effet obtenu est que les résultats retournés se rapprochent à chaque itération un peu plus du centre (centroid) de la liste D+ des contenus évalués positivement par l’utilisateur. Avec cette technique, on voit qu’il est possible d’affiner la requête initiale des utilisateurs au fur et à mesure que ceux-ci fournissent des jugements de pertinence sur des documents consultés. Le système de recommandation est donc doté d’une boucle de retour qui permet au même système de reformuler des recommandations plus pertinente en favorisant ou écartant certains contenus.
Avantages et inconvénients
Avantage: ce type de recommandation objet n’a pas besoin d’une large communauté d’utilisateurs pour pouvoir effectuer des recommandations. Une liste de recommandations peut être générée même s’il n’y a qu’un seul utilisateur.
Inconvénients: certains attributs peuvent être extraits automatiquement d’un contenu, comme par exemple pour un document de texte, on peut relativement facilement déduire certaines propriétés sémantiques automatiquement. On voit aussi qu’en pratique, des caractéristiques et propriétés comme le genre d’un livre ou la liste des acteurs dans un film, sont généralement fournis pas les créateurs du livre ou du film et sont généralement offerts sous forme électronique. Ce qui reste plus problématique, c’est l’acquisition de caractéristiques subjectives et qualitatives… Des propriétés, comme par exemple le style, le design… peuvent difficilement être acquises automatiquement, et devront plutôt être introduites manuellement avec tout ce que ça implique, comme le coût, les éventuelles erreurs…
Recommandation Sociale
Recommander des choses sur la base du comportement passé des utilisateurs similaires, en effectuant une corrélation entre des utilisateurs ayant des préférences et intérêts similaires. On utilise des méthodes qui collectent et analysent des données sur le comportement, les activités, les préférences des utilisateurs et des algorithmes tentent de prédire ce que l’utilisateur aimera en cherchant des utilisateurs qui ont les mêmes comportements que l’utilisateur à qui l’on souhaite faire des recommandations. L’idée sous-jacente est de dire que si un personne A a la même opinion (ou les même goûts) qu’une personne B sur un objet x, alors la personne A a plus de chance d’avoir la même opinion que B sur un autre objet y, plutôt que d’avoir la même opinion que quelqu’un choisi au hasard pour l’objet y. L’idée de base est donc de dire que si des utilisateurs ont partagés des mêmes intérêts dans le passé, il y a de fortes chances qu’ils partagent aussi les mêmes goûts dans le futur.
Les techniques de recommandation sociale (filtrage collaboratif) sont classées en 2 sous-types:
Les algorithmes de recommandation sociale utilisent généralement différentes variantes d’un mécanisme basé sur le voisinageproche (user-based nearest neighborhood approach). Dans cette approche, un nombre d’utilisateurs (peer users / nearest neighbors / plus proches voisins) est identifié et sélectionné sur la base de la similarité de leurs intérêts et préférences avec l’utilisateur actif. On utilise alors principalement les ratings (par ex: films) de ces utilisateurs “voisins” pour calculer des similarités avec l’utilisateur actif. Pour chaque produit p que l’utilisateur n’a pas encore vu, une prédicition est faite en se basant sur les ratings de p assignés par le panel d’utilisateurs voisins. Cette méthode suppose 2 conditions initiales (inconvénients):
On assume que si des utilisateurs ont eu des goûts similaires dans le passé, ils auront aussi des goûts similaires dans le futur.
Les préférences des utilisateurs restent stables et cohérentes dans le temps.
Pour bien comprendre, on peut imaginer un tableau ou matrice de ratings de films, avec sur un axe les utilisateurs et sur un autre les films. Chaque cellule de la matrice contient le rating donné par un utilisateur pour un film. Un signe “+” indique que l’utilisateur a aimé le film, un signe “-” qu’il ne l’a pas aimé, pas de signe signifie qu’il n’a pas d’avis particulier sur ce film. Pour pouvoir prédire si Ken apprécierait le film “Fargo” et éventuellement lui recommander ce film, on compare les ratings de Ken à ceux des autres utilisateurs sélectionnés. On peut alors voir que Ken et Mike ont des ratings identiques, et que Mike a aimé le film Fargo, on pourrait alors prédire que Ken aimera aussi ce film et lui faire cette suggestion (user-centric).
Au lieu de se baser uniquement sur l’utilisateur le plus semblable, la prédiction est normalement calculée à partir de la moyenne pondérée des ratings de plusieurs utilisateurs. Le poids donné au rating de chaque utilisateur est déterminé par le degré de corrélation entre cet utilisateur et l’utlisateur pour qui on désire faire la recommandation. Pour mesurer le degré de corrélation entre 2 utilisateurs, on fait appel généralement au coefficient de corrélation de Pearson r. D’autres indicateurs de mesure de la similarité ou proximité entre utilisateurs sont aussi utilisés comme la corrélation de Ringo, ou le coefficient de corrélation de Spearman. Le coefficient de corrélation de Pearson se calcule à partir des valeurs présentes dans la matrice et peut prendre une valeur allant de +1 (forte corrélation positive) à -1 (forte corrélation négative). Par exemple, un coefficient de corrélation 0.70 entre 2 utilisateurs indiquerait une bonne similarité de leurs intérêts. On introduit aussi souvent dans le calcul de la mesure de Pearson un facteur de pondération afin de prendre en compte et pondérer le fait que certains utilisateurs ont toujours tendance à donner seulement de bons ratings, ou que d’autres ne vont jamais donné le rating maximum à un produit.
Les systèmes de recommandation doivent généralement aussi gérer un grand nombre d’utilisateurs. Faire des recommandations à partir des ratings de millions d’utilisateurs peut avoir de sérieuses implications en termes de performance. Ainsi, qua
nd le nombre d’utilisateurs atteint un certain seuil, une sélection des “meilleurs” voisins doit être faite. Pour déterminer quels sont les voisins les plus pertinents à sélectionner, on utilise généralement l’algorithme du k-nearest neighbor (k-NN) qui permet de sélectionner seulement les k meilleurs voisins ayant la plus haute valeur de corrélation. Une autre approche (correlation-thresholding) serait de sélectionner seulement les voisins possédant une corrélation plus grande qu’un certain seuil. Le problème dans ces deux approches réside dans le fait de sélectionner le bon nombre k d’utilisateurs voisins à prendre en compte ou de déterminer la bonne valeur du seuil de corrélation. Si le nombre k est trop petit ou si le seuil de similarité est trop élevé, le nombre d’utilisateurs voisins pris en compte sera trop réduit pour effectuer une bonne prédiction (problème du reduced coverage/couverture réduite). Dans le cas contraire, lorsque que k est trop élevé ou que le seuil est trop faible, l’ensemble du panel de voisins est trop large (trop d’utilisateurs avec un degré de similarité limité), ce qui amène du bruit additionnel dans les prédictions. Plusieurs travaux et situations réelles ont montré qu’un panel composé de 20 à 50 voisins donne de bons résultats.
On n’est pas non plus limités aux ratings ou like/dislike, on peut aussi se baser sur des données plus implicites en observant le comportement de l’utilisateur sur le site, par opposition à la récolte de données explicite comme l’est le rating. On peut observer par exemple quelle musique il a écouté, quel article il a lu, et on croise ses infos avec celles du reste des utilisateurs afin de lui proposer de nouvelles suggestions.
La recommandation sociale user-centric a cependant ses limites. Lorsqu’il s’agit d’un gros site qui gère des millions d’utilisateurs et un catalogue de milliers de produits, il faut scanner un grand nombre de voisins potentiels, ce qui rend impossible la recommandation en temps réel. Pour palier ce problème, les gros sites implémentent souvent une technique différente plus apte au traitement préalable des données hors-ligne (offline preprocessing), la recommandation sociale item-centric (à ne pas confondre avec la recommandation objet).
Cette autre approche, appelée aussi item-to-item, propose une inversion de l’approche user-based nearest neighbor. Au lieu de mesurer la corrélation entre des utilisateurs, les ratings sont utilisés pour mesurer la corrélation entre les contenus (films), en s’aidant toujours du coefficient de corrélation de Pearson, mais cette fois-ci appliqué au contenu. Si par exemple les ratings des deux films “Fargo” et “Pulp Fiction” ont une parfaite corrélation, c’est-à-dire qu’ils ont reçu les mêmes ratings (positif, négatif ou nul) de la part des utilisateurs, on peut ainsi prédire que Ken aimera le film “Fargo” car il a aimé “Pulp Fiction” (les ratings des utilisateurs sur ces deux films sont parfaitement corrélés).
Pour le dire autrement, l’approche item-centric propose de rechercher en premier lieu des contenus similaires et ensuite de faire une recommandation à l’utilisateur. Cette approche permet de faire un traitement préalable sur la matrice pour déterminer les contenus similaires et ainsi pouvoir effectuer des prédictions en temps réel, contrairement à l’approche user-centric très gourmande en mémoire.
Autant le coefficient de corrélation de Pearson est très utilisé pour déterminer des utilisateurs similaires (cas de la recommandation sociale user-centric), dans l’approche item-centric, on utilise plutôt comme indicateur de mesure de similarité entre items un autre indicateur qu’on appelle de similarité cosinus ajustée. Les valeurs possibles pour cet indicateur vont comme dans le cas de mesure de Pearson de +1 (forte similarité positive) à -1 (forte similarité négative). Une fois que la similarité entre les items a été établie à l’aide de la similarité cosinus ajustée, on peut alors prédire un rating pour un item grâce aux ratings effectués par l’utilisateur sur les items similaires.
Dans l’approche item-centric, l’idée est donc de construire à l’avance la matrice de similarité entre items. Et en temps réel, on peut facilement ensuite déduire la prédiction de recommandation (le rating) d’un produit pour un utilisateur actif en déterminant depuis la matrice déjà construite quels sont les produits les plus similaires, et en calculant la valeur moyenne de ratings sur ces produits effectués par les utilisateurs voisins.
Avantages et inconvénients
Avantage: L’approche purement de recommandation sociale n’exploite pas ou ne demande aucune connaissance sur les contenus eux-même. Par exemple, dans le cas d’un magasin de vente de livres en ligne, le système de recommandation collaboratif n’a pas besoin de savoir le type de contenu du livre, son genre, qui en est l’auteur, etc… Pas besoin de se baser sur l’analyse des propriétés intrinsèques d’un livre ou d’un contenu, la recommandation sociale est capable de recommander des contenus sans avoir besoin de comprendre le sens ou la sémantique du contenu lui-même. Les informations propres au livre n’ont pas besoin d’être introduite dans le système.
Inconvénients:
Scalability: souvent, les plate-formes sur lesquelles sont utilisés les filtres collaboratifs ont des millions d’utilisateurs, de produits et contenus. Ça demande donc beaucoup de puissance de calcul pour pouvoir proposer des suggestions aux utilisateurs. La recommandation sociale de type user-centric est aussi appelée memory-based, car la base de données des ratings est maintenue en permanence en mémoire dans le serveur et utilisée directement pour générer des recommandations à l’utilisateur actif. Bien que cette approche memory-based soit théoriquement plus précise, car elle a disposition en permanence et en temps réel toutes les données pour générer les recommandations, elle souffre de problèmes de scalability pour des bases de données de millions d’utilisateurs et de millions de contenus. Dans une approche item-centric ou model-based, les données sont préalablement traitées hors-ligne. Ensuite lors de l’exécution de l’application ou service web, le modèle “appris” ou pré-traité sera utilisé pour effectuer les prédictions. L’approche model-based permet d’éviter le problème de scalability.
Cold Start: les systèmes de recommandation sociale ont besoin de beaucoup de données et beaucoup d’utilisateurs pour être performants. Le lancement d’un service de recommandation peut souffrir au début du manque d’utilisateurs et d’informations sur ceux-ci.
Sparsity (Rareté): le nombre de produits ou contenus est énorme sur certaines plates-formes, et même les utilisateurs les plus actifs auront noté ou valorisé qu’un tout petit sous-ensembe de toute la base de données. Donc, même l’article le plus populaire n’aura que très peu de bonnes notes. Dans une telle situation, deux utilisateurs auront peu d’articles valorisés en commun, ce qui rend plus difficile la tâche de corrélation. C’est une situation qu’on retrouve lorsque le système dispose d’un ratio élevé de contenu par rapport aux utilisateurs, et qu’on retrouve aussi souvent au stade initial du lancement du service de recommandation, ce qui nous ramène au problème de cold start (qui peut être vu comme un cas spécial du problème de rareté).
Recommandation Hybride
Une combinaison des trois approches ci-dessus. Les méthodes hybrides sont de plus en plus utilisées, car elle permettent de résoudre des problèmes comme le cold start et la sparsity (rareté) qu’on retrouve dans une approche de recommandation uniquement sociale. D’autre part, si par exemple on considère 2 utilisateurs avec les mêmes goûts mais qui n’ont pas évalué ou “raté” des objets en commun, un filtrage collaboratif pur ne les considérera pas comme similaires ou voisins. Rappelons que la mesure de similarité standard ne prend en compte que les éléments pour lesquels l’utilisateur actif et l’utilisateur à comparer ont effectué un rating. L’idée est alors de pouvoir assigner une valeur par défaut aux éléments qui ont été “ratés” seulement par un des deux utilisateurs, afin d’améliorer la qualité de prédiction en cas de rareté (sparsity). En appliquant préalablement un algorithme de recommandation objet sur les contenus pour en exploiter leurs descriptions et caractéristiques, accompagné ensuite d’un algorithme de recommandation sociale pour effectuer les recommandations peut aider à résoudre ces limitations. Autrement dit, pour les cas de rareté (sparsity), lorsque peu d’items ont été évalués par les utilisateurs et qu’un filtrage collaboratif n’est pas possible, ce qu’on fait, c’est qu’on assigne en premier lieu un pseudo-rating ou vote artificiel par défaut à l’utilisateur sur les contenus disponibles en utilisant préalablement un algorithme objet, puis on applique ensuite sur la matrice (contenant peu de vrais rating et beaucoup de pseudo-ratings) un filtrage collaboratif.
Exemples:
Amazon utilise les 3 approches (personnalisée, sociale et objet). Amazon possède un système très sophistiqué, les recommandations sont d’une part personnalisées en se basant sur le comportement individuel passé de l’utilisateur (historique de navigation et historique d’achat), et d’autre part Amazon utilise aussi les caractéristiques de l’article lui-même (recommandation objet) et les comportements d’autres personnes (recommandation sociale). Tous ceux qui ont déjà fait un achat sur Amazon ont probablement dû lire le message de la part d’Amazon qui nous dit “les gens qui ont acheté x ont aussi acheté y“. Cette approche est tout simplement l’approche item-based nearest neighbor (item-centric ou item-based collaborative filtering) qu’on a décrit auparavant. Il semblerait que le système de recommandation d’Amazon représente plus du 30% du CA global de la société (en 2009)!
Netflix est aussi un bon exemple de système hybride. Il propose des recommandations en comparant les habitudes de visionnage des films d’utilisateurs similaires (recommandation sociale) et suggère aussi des films qui partagent des caractéristiques avec des films que l’utilisateur a noté positivement (recommandation objet).
Google, lui se focalise aussi sur une combinaison de 3 approches pour améliorer son produit phare qui est son moteur de recherche:
Recommandation Personalisée:
Google customise nos résultats de recherche, quand cela est possible, en se basant sur notre localisation et/ou nos dernières recherches.
Lorsqu’on est connecté à notre compte Google, il propose un contenu encore plus pertinent en fonction de notre historique de recherche.
Recommandation Sociale:
L’algorithme du PageRank est de manière intrinsèque un outil basé sur de la recommandation sociale dans la mesure ou il utilise les liens entre les pages web.
L’utilisation de contenus provenant de nos cercles de Google+ est aussi une forme de recommandation sociale.
Recommandation Objet
Google utilise aussi une approche sémantique pour sa fonction « Did you mean » de son moteur de recherche.
Pandora vs Last.fm
La différence entre les approches de recommandation objet et de recommandation sociale (collaborative) peut être illustrée en comparant deux services de radio en ligne que sont Pandora (seulement disponible aux USA) etLast.fm.
Pandorautilise principalement une approche de recommandation objet. Le système se base sur les propriétés de la chanson et/ou de l’artiste, c’est à dire il décompose dans un premier temps les morceaux de musique afin de mettre en évidence ses propriétés intrinsèques. Chaque morceau de musique disposerait de plus de 400 attributs, permettant de déterminer une sorte de code génétique de la chanson (Music Genome Project). En comparant les propriétés similaires entre différents morceaux, le système arrive alors à nous proposer de nouvelles chansons à écouter, c’est-à-dire une sorte de station radio qui diffuse de la musique avec des propriétés susceptibles de correspondre à nos goûts. L’utilisateur peut ensuite indiquer s’il aime ou pas le morceau en écoute, et permet ainsi à Pandora d’affiner son filtre de recommandation en privilégiant (ou pas) certains attributs selon l’information venue en retour de l’utilisateur.
Last.fm lui utilise un filtre de recommandation sociale (collaborative). Le service crée une station de radio personnalisée en observant quels sont les groupes, artistes et chansons que l’utilisateur a écouté régulièrement et les compare avec les comportements d’écoute d’autre utilisateurs. Last.fm va alors proposer des morceaux fréquemment écoutés par des utilisateurs ayant des goûts similaires.
Chaque type d’approche a ses avantages et inconvénients. En l’occurrence Last.fm requiert beaucoup d’information sur les habitudes d’écoute des utilisateurs afin de produire un système de recommandation efficace (problème du cold start). Pandora lui au contraire a besoin de très peu d’information sur l’utilisateur pour démarrer une radio personnalisée, mais doit disposer d’une base de données gigantesque sur le “génome” de chaque chanson.
Netflix Prize
De 2006 à 2009, Netflix a parrainé un concours, le Netflix prize, offrant un prix de $1’000’000 à celui qui à partir d’un set de données de plus de 100 millions de ratings de films pourrait offrir des recommandations 10% plus précises que celles générées par le système original de la compagnie Netflix. Le 21 septembre 2009, le prix a été attribué à une équipe appelée BellKor’s Pragmatic Chaos. Les gagnants avaient misé sur un mélange de centaines d’approches algorithmiques et méthodes prédictives qui réunies ensemble permettent d’être plus performant dans la prédiction. La solution la plus performante semble donc bien s’appuyer sur un ensemble de méthodes algorithmiques plutôt que sur le raffinement et l’optimisation d’une seule technique spécifique.
Pour l’anecdote, le Netflix prize n’a pas été renouvelé en 2010, car malgré le fait que le set de million de données fournies aux participants du concours aient été rendues anonymes pour préserver l’identité des clients, deux chercheurs de l’Université du Texas ont été capables d’identifier des utilsateurs présents dans le set de données utilisé lors du concours en associant et croisant ces données avec des ratings de films soumis sur l’Internet Movie Database (IMDb). Il s’en est suivi qu’en décembre 2009, un des utilisateurs anonymes du set de données a poursuivi Netflix pour violation de la législation américaine en terme de confidentialité.
Efficacité d’un algorithme de recommandation
On a vu que la recommandation sociale (filtrage collaboratif) a l’avantage contrairement à la recommandation objet de permettre d’effectuer des prédicitions même lorsqu’il y a peu de information associée au contenu à recommander ou lorsque que le contenu est difficile d’analyser automatiquement (idées, opinions…) Mais la recommandation sociale souffre aussi d’inconvénients comme le cold start et le problème de rareté (sparsity).
Evaluer l’efficacité des algorithmes de recommandation est loin d’être trivial. En premier lieu, parce que différents algorithmes peuvent être meilleurs ou moins bons en fonction du set de données sélectionné et sur lequel ils sont appliqués. D’autre part, les objectifs fixés par un système de recommandation peuvent être divers et variés. Un système de recommandation peut être mis en place pour estimer avec exactitude la note que donnerait un utilisateur à un élément, alors que d’autres auront comme objectif principal de ne pas proposer des recommandations erronées.
On peut donc légitimement se demander jusqu’à quel point ces différentes méthodes de recommandation sont réellement efficaces. Pour déterminer l’efficacité d’un système, des indicateurs comme la précision et le recall sont utilisés.
La précision est un indicateur qui représente la qualité de la recommandation, c’est-à-dire à quel point les suggestions proposées sont conformes aux intérêts de l’utilisateur:
précision = nbre de suggestions pertinentes / nbre de suggestions
Le recall indique combien de suggestions pertinentes ont été recommandées à l’utilisateur par rapport au nombre total de suggestions pertinentes disponibles dans le système.
recall = nbre de suggestions pertinentes proposées à l’utilisateur / nbre de suggestions pertinentes totale
L’indicateur de précision permet de déterminer la probabilité qu’un élément recommandé soit pertinent.
L’indicateur de recall permet de déterminer la probabilité qu’un élément pertinent soit recommandé.
On utilise aussi des techniques statistiques pour mesurer l’efficacité d’un algorithme de recommandation. L’idée c’est d’évaluer la précision de la prédiction effectuée par le système en comparant les prédicitions avec les choix qu’aurait fourni l’utilisateur dans un cas réel. On utilise par exemple l‘Erreur Moyenne Absolue (MAE) qui mesure la déviation des recommandation prédites avec les choix réels effectués par les utilisateurs. Plus l’erreur moyenne absolue est faible, meilleure est la prédicition.
Pour conclure, la meilleure mesure de l’efficacité d’un algorithme de recommandation et de la pertinence des suggestions c’est finalement la satisfaction de l’utilisateur, qui n’est pas toujours facile à bien identifier.
Déjà le 3e dossier de Nico, qui nous chauffe cette fois-ci les neurones en nous parlant des algorithmes, dont voici un rappel du teaser:
“De tout temps (même si au début ils n’étaient pas clairement nommés), l’homme a utilisé des algorithmes. De la méthode pour chasser le mammouth à celle pour calculer pi. De la recette de cuisine à l’intelligence artificielle. Quels sont les grand algorithmes de l’histoire? Quelles furent les grandes étapes de l’histoire des algorithmes? Mais au fait qu’est-ce qu’un algorithme?”
“I am thinking about something much more important than bombs. I am thinking about computers.” – John von Neumann, 1946
“Nous sommes automates dans les trois quarts de nos actions” – Leibniz
“Je méprise profondément ceux qui aiment marcher en rang sur une musique: ce ne peut être que par erreur qu’ils ont reçu un cerveau. Une moelle épinière leur suffirait amplement.” – Albert Einstein
Pour un troisième dossier, on s’attaque aujourd’hui à un sujet très vaste, sans aucun doute le plus vieux de l’histoire des sciences… Lors du dossier sur Pi, nous avions pu découvrir que dès que l’homme a su écrire, il a parlé de la constante célèbre. Force est de constater que depuis que l’homme existe, il existe des algorithmes même si ce n’est que très récemment (au début du XXe siècle) qu’une définition formelle à commencé à se montrer. Je serais même tenté d’affirmer que certains animaux usent d’algorithmes, mais devant ma méconnaissance du sujet, je laisserai des personnes plus compétentes apporter leur contribution une fois le dossier assimilé!
Un algorithme? Mais koikeskecédonc?
Depuis que l’homme existe donc et encore aujourd’hui, tout le monde utilise tous les jours, toutes les heures des algorithmes… Pour autant peu de personnes connaissent le mot et moins encore la définition exacte et cela est bien compréhensible tant elle est finalement complexe! Pourtant, l’idée est assez simple, voire même naturelle : une méthode qui, à partir de plusieurs données permet d’obtenir un résultat. Si cette définition n’est pas suffisamment précise pour bâtir une théorie mathématique, elle est suffisante pour donner à ce stade quelques exemples.
Commençons donc par le plus célèbre des algorithmes, celui que l’on a tous utilisé au moins une fois, celui qui est aussi vieux que l’invention du feu (ou presque) : la recette de cuisine! Dans toute bonne recette, à l’image de celle ci-dessous (provenant de l’excellent blog la foodbox), on a exactement les mêmes éléments…
Le nom nous permet de savoir à quoi sert cette recette, la liste d’ingrédients assure que l’on ait tous les outils et éléments nécessaires à sa réalisation. La procédure à suivre permet à n’importe qui, cuisinier ou non, intelligent ou non, de produire cette réalisation complexe. Les variantes et autres tests permettent de s’adapter à la situation et à l’envie.
Cet exemple traduit très bien l’idée partagée par nombre de scientifiques de la notion d’algorithme après l’apparition de ce mot au IXe siècle. L’origine du mot algorithme est arabe, il correspond à la traduction du nom du mathématicien Al-Khwārizmī qui a accessoirement écrit un ouvrage qui a permis de propager en Europe l’écriture décimale positionnelle des nombres inventée par les Indiens (c’est celle que nous utilisons encore aujourd’hui). S’il n’y a pas aujourd’hui de définition simple communément acceptée de la notion d’algorithme, on y retrouve toujours les idées suivantes :
Le dictionnaire de symboles, de mots est limité. Il se veut aussi simple et précis que possible. Dans le cas de la recette, ce dictionnaire de symboles est l’alphabet occidental accompagné de la ponctuation et des chiffres;
On doit obtenir le résultat en un nombre fini d’étapes;
Il doit pouvoir être suivi par un humain en ne nécessitant aucune intelligence, tout au plus, la capacité d’exécuter les différentes instructions. Cet aspect est particulièrement important pour les recettes. Si elles sont largement diffusées et utilisées, c’est entre autres parce qu’elles permettent d’obtenir un résultat proche du restaurant sans aucune connaissance préalable de cuisine.
À partir d’une définition aussi générale, vous comprendrez pourquoi j’affirme sans peur que c’est le plus vieux sujet scientifique : partout où il y a routine, méthode, transmission d’un savoir-faire, il y a algorithme! On pourrait donc pousser le vice jusqu’à considérer que les méthodes de chasse de nos ancêtres préhistoriques, qu’ils inscrivaient selon certaines théories sur les murs des grottes, étaient bel et bien des algorithmes.
Quelques algorithmes au cours de l’histoire
Pour autant, ce n’est que beaucoup plus tard qu’est généralement placée la date des premiers algorithmes principalement parce qu’il fallut attendre l’apparition de l’écriture pour avoir des traces des méthodes employées et non seulement de leur résultat. Dans le dossier sur Pi, je vous avais présenté une des premières apparitions du nombre sur le papyrus de Rhind. Ce papyrus, qui date de -2000, contient aussi des traces d’un algorithme pour réduire plusieurs fractions au même dénominateur. De manière plus générale, toutes les méthodes pour calculer Pi sont des algorithmes et sont un bon exemple de la diversité du sujet.
Datant cette même période des débuts de l’écriture, entre -3500 et -1500 av. J.-C., on a retrouvé des tablettes babyloniennes indiquant comment calculer un inverse, effectuer une division, etc. Ces opérations peuvent paraître simples aujourd’hui, mais en tant qu’algorithmes, les méthodes devenaient applicables par n’importe qui (sans culture ni éducation nécessaire). Ces méthodes permettaient de faire facilement des multiplications, des règles de trois, etc. Pour l’anecdote, cette civilisation ne comptait pas en base 10 (avec 10 chiffres), mais en base 60, cela simplifie les divisions. Le choix de la base 60 s’explique probablement du nombre de phalanges des doigts d’une main (sans compter le pouce) et du nombre de doigts de la main (5×12=60). À titre d’anecdotes à ressortir en dîner de famille, c’est parce que les Babyloniens comptaient en base 60 que nous comptons 60 minutes dans une heure.
Il n’y a pas que ces vieilles civilisations qui s’aidaient d’algorithmes pour effectuer des opérations simples. Lorsque vous posez une division, vous effectuez des étapes mécaniques sans forcément savoir pourquoi elles fonctionnent, mais au contraire, vous avez appris par cœur un rituel qui permet de vite effectuer l’opération. Parmi les outils originaux pour effectuer des opérations simples, l’image ci-dessous (provenant de Wikipedia) représente l’invention de Lucas-Genaille : un système de réglettes pour effectuer la multiplication de deux grands nombres.
Pour effectuer la multiplication, il suffit de placer les réglettes correspondant au nombre choisi et de suivre les flèches noires comme sur la figure ci-dessous (provenant tout autant de Wikipedia).
Dans cet exemple, on effectue la multiplication de 52749 par 4 : en suivant les flèches noires, on trouve 210996. Ces réglettes furent commercialisées jusqu’en 1911! Ce système aussi amusant qu’ingénieux est une goutte d’eau au milieu des autres méthodes permettant de faire des opérations arithmétiques.
De tout temps, les algorithmes ont donc été au centre de l’activité humaine, mais il fallut attendre 1900 pour voir apparaître un début de formalisation de ce concept avec le 10e problème de Hilbert, nous y revenons dans la prochaine partie. Il n’a pas fallu attendre la formalisation pour voir apparaître des algorithmes très complexes. Jusqu’à cette période, le mot algorithme était le plus souvent associé à Euclide et une manière simple de présenter la notion d’algorithme était de donner l’exemple du célèbre calcul.
Algorithme d’Euclide
Euclide écrit au troisième siècle av. J.-C. 13 livres “les éléments“. Les premiers traitent de géométrie alors que les livres VII, VIII et IX posent les bases de la théorie des nombres. C’est justement dans le 7e livre qu’Euclide présente une méthode pour calculer le plus grand diviseur commun à deux nombres. Le plus grand diviseur commun de a et b, PGCD pour les intimes, est le plus grand nombre qui divise a et b (c’est-à-dire le plus grand nombre p tel que a/p et b/p soient entiers). Nous ne reviendrons pas ici sur la preuve du fonctionnement de l’algorithme ni sur la théorie des nombres, car ce n’est pas le sujet.
Bien qu’il soit très vieux, cet algorithme reste d’actualité et contient tous les éléments d’un algorithme “moderne”. Son fonctionnement tel que décrit dans le livre est résumé par la figure suivante. Pour les puristes, l’algorithme présenté ici est celui décrit par Euclide dans son livre et non l’amélioration utilisant la division euclidienne généralement présentée.
C’est un algorithme très utile et encore très utilisé, car il à été généralisé pour plusieurs résultats, par exemple, il permet de calculer les coefficients de l’identité de bezout qui sert dans le système de cryptage RSA, énormément utilisé pour la sécurisation du e-commerce. C’est l’un des plus vieux algorithmes encore en activité.
On y retrouve encore nombre d’éléments de la recette de cuisine :
Des déclarations : trois variables sont déclarées (a, b et c) même si avec le seul schéma ci-dessus, cela est sous-entendu. Dans la recette, la liste d’ingrédients joue ce rôle de déclaration. En plus de cela, est comme c’est parfois précisé, il faudrait “déclarer” quels sont les ustensiles nécessaires.
Des affectations : les trois variables se voient affecter plusieurs résultats tout au long de l’algorithme. Dans la recette, c’est le contenu des bols et autres assiettes qui joue ce rôle d’affectation.
Une séquence d’instruction : les flèches sur le diagramme permettent de savoir dans quel ordre effectuer les opérations. Dans la recette, c’est l’ordre des phrases.
Des tests : “c=1” par exemple. Dans la recette, on trouvait le test “est-ce que le chou est croquant?”
Une boucle : dans cet algorithme, la même opération est répétée jusqu’à ce que l’on trouve le PGCD. Dans la recette, on fait cuire le chou tant qu’il est “croquant” jusqu’à ce qu’il devienne “un peu croquant”.
Et surtout, l’algorithme d’Euclide correspond bien à l’idée de ce qu’est un algorithme présenté en début de dossier. Les souhaits présentés dans la première liste correspondent à ce que l’on attend d’un algorithme alors que cette nouvelle liste correspond à 5 outils qui permettent de construire des objets correspondant à la première intention. Deux questions s’imposent alors : ces 5 outils sont-ils indispensables? Et surtout est-ce qu’avec ces seuls 5 outils, on peut construire tous les algorithmes correspondants aux désirs énoncés? Avant de répondre à ces deux questions, nous allons faire un petit écart historique pour dire deux mots sur l’événement qui amena à une meilleure définition des algorithmes et déclencha les nombreux travaux qui aboutirent à leur réponse.
La fin du formalisme de Hilbert
En 1900, au congrès international des mathématiciens, Hilbert présenta 23 problèmes non résolus qui selon lui étaient les plus importants du moment. Un certain nombre sont aujourd’hui résolus : c’est-à-dire que l’on a montré qu’ils étaient soit vrais soit faux. Ou alors on a prouvé qu’ils étaient indécidables, qu’on ne peut pas dire s’ils sont vrais ou faux; ils sont indépendants de la théorie considérée. Un équivalent aujourd’hui de cette démarche est les problèmes du prix du millénaire pour lesquels l’institut mathématique Clay offre un million de dollars à qui apporte une solution (et pour information, cette somme ne serait qu’un pourboire tant la plupart de ces problèmes sont importants et ont plusieurs applications cruciales telles que la cryptographie).
Hilbert dans sa démarche visait à montrer une certaine “perfection” des mathématiques en demandant la démonstration de trois résultats :
La complétude des mathématiques : c’est-à-dire que tout énoncé peut être confirmé ou infirmé. En d’autres termes que l’on peut construire une théorie sans aucune proposition indécidable;
La consistance des mathématiques : c’est-à-dire qu’il n’existe pas d’énoncé contradictoire, qui serait vrai ainsi que son contraire;
La décision des propositions mathématiques : c’est-à-dire qu’il existe une procédure s’exécutant en un temps fini permettant de démontrer qu’un énoncé mathématique est vrai.
Ironie de l’histoire, alors qu’Hilbert souhaitait que tous ces énoncés soient vrais, il fallut moins de 50 ans pour démontrer q
u’il n’existait pas de théorie mathématique suffisamment complexe pour contenir les opérations élémentaires (addition, multiplication, inverse…) à la fois consistante et complète. Et surtout qu’une procédure qui permet de décider si un énoncé est vrai en un temps fini n’existe pas. Une défaite pour la pensée de Hilbert, mais grâce à ses problèmes, une avancée exceptionnelle des mathématiques et de la connaissance de leurs limites.
La dernière question, qui correspond au 10e problème de Hilbert, parle sans s’en rendre compte d’algorithme. En effet, Hilbert souhaite trouver une méthode qui s’exécute en un nombre fini d’étapes pour obtenir son résultat. Et pour apporter une solution à ce problème (la solution est que c’est impossible, mais ça reste une solution), il fallut bien définir la notion d’algorithme. Et grâce à cette bonne définition, on put en cerner certaines limites.
La caractérisation précise des algorithmes a pu se faire en définissant la notion de fonction calculable, c’est-à-dire une fonction qui coïncide avec la description faite en début de dossier. Beaucoup de très grands noms des mathématiques du XXe siècle ont proposé une définition de la calculabilité. Il y a d’abord Godel, qui après avoir détruit les rêves de Hilbert sur l’incomplétude et la cohérence présenta une définition de “fonctions récursives” conçues sur quelques règles simples. Alonzo Church démontra l’impossibilité du problème de décision posé par Hilbert, résultat qui a aujourd’hui son nom. Il créa de son côté le lambda calcul, qui tout comme les fonctions récursives de Godel, avait pour but de représenter les algorithmes. Enfin, Turing proposa encore une autre construction, les machines de Turing, dont nous allons reparler tout de suite.
Entre 1931 et 1936, divers scientifiques brillants ont proposé plusieurs définitions de fonctions calculables qui paraissaient toutes aussi pertinentes. En fait toutes ces constructions sont équivalentes, les algorithmes que l’on peut construire avec sont les mêmes! Il n’y avait donc en fait qu’un ensemble de fonctions, de méthodes que l’on pouvait fabriquer et c’est ce que l’on appelle aujourd’hui les algorithmes. Dans la partie suivante, nous allons voir l’une de ces constructions, sans aucun doute la plus célèbre : la machine de Turing.
Machine de Turing
Il n’a pas été facile de choisir la définition de fonction calculable que j’allais présenter pour ce dossier. À vrai dire, je ne savais pas qu’il y en avait autant et surtout celle des machines de Turing était de loin celle qui me parlait le moins, me paraissait la moins intuitive. Puis, j’ai lu l’extrait traduit de “on the computable numbers, with an application to the Entscheidungsproblem” que vous pourrez trouver dans “histoires d’algorithmes”, livre dont la référence complète est donnée en fin de dossier. Si vous le pouvez, lisez le texte directement, c’est limpide et explique très simplement la construction de ces “machines”.
Turing cherche donc à formaliser l’opération que l’on appelle intuitivement “calcul”. Il commence par énumérer les différents éléments nécessaires pour faire un calcul. Le calcul est fait sur une feuille où l’on écrit les symboles les uns après les autres sur une ligne. Il propose donc de modéliser cela par un ruban de papier quadrillé. Il explique ensuite qu’on doit se limiter à un nombre fini de symboles tels que dans notre alphabet et précise que l’un de ces symboles doit être repéré comme étant le “0”, la case vierge.
Tout comme nous ne regardons qu’une étape de recette à la fois, Turing poursuit en disant qu’un calculateur ne peut observer qu’un nombre de symboles fini fixé à chaque étape. Et tout comme le plat est dans un état bien déterminé et le cuisinier dans un état d’esprit bien précis avant le début d’une étape, il précise que sa machine est dans un nombre fini d’états au moment de l’observation.
Il explique ensuite que la donnée de l’état du calculateur et de l’observation des symboles permet d’effectuer deux opérations :
changer l’ordre des cases en échangeant une case observée par une case voisine ;
remplacer le symbole dans une case du ruban par un nouveau.
Lorsque l’on suit une recette de cuisine, on n’effectue pas autre chose, on ajoute et retire des ingrédients, on les mélange… Si l’on décompose la recette au maximum en opérations simples, on arrive à rester dans la modélisation de Turing.
Et… C’est tout! À partir de cette construction, on arrive à modéliser toutes les choses que nous appelons ou soupçonnons être à ce jour des “algorithmes”. En fait, ce que nous appelons aujourd’hui une machine de Turing est encore plus simple et permet de fabriquer exactement les mêmes systèmes : l’alphabet n’a que deux symboles (0 et 1), on observe une seule case à la fois et on ne peut utiliser que les cases directement voisines à la case observée.
Il fut montré que les machines de Turing sont équivalentes à toutes les autres fonctions “calculables” de l’époque et on ne connaît pas à ce jour de “méthode” exécutable par une machine, un humain ou un animal qui ne soit pas modélisable par l’une d’elles. Mais pour autant, est-ce que ces fonctions calculables correspondent bien à l’intuition de la notion d’algorithme? Alonzo Church en était convaincu et cette hypothèse est aujourd’hui connue sous le nom de “thèse de Church“. Autant dire tout de suite que cette conjecture à peu d’espoir d’être démontrée tant elle est plus proche de la philosophie que des sciences (allez donc jeter un oeil à la conférence mise en lien en fin de dossier si le sujet vous intéresse)… D’autant plus que grâce aux raisonnements de Cantor, on peut démontrer que l’ensemble des fonctions calculables est dénombrable. Comme l’ensemble des nombres réels est indénombrable, il existe une infinité de nombres non calculables par des algorithmes! Reste à savoir si ce sont des nombres atteignables dans le monde “réel”.
Savoir calculer ne suffit pas
Une fois la notion de fonction calculable posée et la thèse de Church avancées, nous savions que nous avions en main tous les outils pour créer des algorithmes des plus complexes. Pourtant, cela est encore trop théorique. Dans les faits, avec l’arrivée des ordinateurs, pourtant dotés d’une capacité de calcul énorme (tout en étant parfaitement stupides, ce qui colle bien avec la définition d’un algorithme), on s’est rendu compte qu’une autre limitation empêchait de finir certains calculs.
Dans le cher monde réel, dire que l’on obtiendra un résultat en un temps fini ne suffit pas, parce que cela n’empêche pas par exemple que le temps d’exécution d’un algorithme prenne plusieurs fois l’âge de l’univers pour s’exécuter (sisi, c’est très grand, mais c’est fini). Dans le guide du voyageur galactique par exemple, des habitants d’une planète construisent une machine pour répondre à la grande question sur la vie l’univers et tout le reste et ce n’est que 7 millions et demi d’années plus tard que la réponse, 42, est obtenue!
La complexité algorithmique est l’objet de l’un des 7 problèmes à un million de dollars et déjà traité dans le tout premier épisode du podcast (contrairement à ce que l’on a cru brièvement a l’époque, le problème est toujours ouvert). Ce problème, que l’on résume souvent à “P=NP” est selon la plupart des mathématiciens à la fois le plus important de ceux de l’institut Clay et le plus à même à être résolu par un amateur. Certains problèmes appartiennent à la catégorie P (les plus “simples”) et d’autres a la catégorie NP (les plus complexes), tout l’enjeu du problème est de prouver que ces catégories sont les mêmes. Et pour le démontrer, il suffirait soit de prouver qu’un seul problème NP n’est pas P (on a alors P different de NP) ou qu’un seul problème NP-Complet (classe particulière de problèmes NP qui sont équivalents à tous les autres) est en fait dans P (alors P=NP), voilà pourquoi beaucoup pensent qu’un amateur pourrait apporter une solution.
Ce qui différencie ces problèmes, c’est la complexité des algorithmes que l’on connaît pour les résoudre. La complexité d’un algorithme est un ordre de grandeur du temps qu’il faut pour obtenir un résultat en fonction de la taille des données du problème dans le pire des cas. Prenons un exemple amusant qui a été posé à un ami lors d’un entretien d’embauche.
Imaginons que vous ayez une noix de coco et devant vous un immeuble de n étages. Vous souhaitez savoir à quel étage exactement la noix de coco se casse. La seule solution dans ce cas, et d’aller à chaque étage en commençant par le rez-de-chaussée et de lâcher la noix de coco pour voir si elle se casse (on suppose que la noix de coco ne s’abîme pas, soit elle se casse soit elle reste indemne). Dans le pire des cas, c’est au dernier étage que la noix de coco se casse, il faut donc faire n tests.
Avec deux noix de coco, le problème devient plus intéressant. Ce qui vient tout de suite à l’esprit est de balancer la première noix de coco à la moitié du bâtiment puis en fonction de la casse à la moitié de la moitié restante et ainsi de suite jusqu’à ce qu’elle casse et de finir avec l’autre en testant tous les étages restants.
Mais quitte à séparer le bâtiment en deux parties, on peut le séparer en 3, 4, 5 ou plus généralement k parties. Il faudra alors au pire des cas que l’on effectue k tests avec la première noix de coco puis n/k tests (les étages restants) avec la deuxième noix de coco. On effectue donc opérations. Il s’agit alors de trouver pour quel k on effectuera le moins d’opérations.
C’est à dire de trouver le nombre m tel que pour toutes les valeurs de k, soit supérieur à m. Autrement dit que est supérieur à zéro pour tous les k. Comme k est supérieur à zéro, cela revient à trouver le minimum du polynôme .
Pour résoudre un polynôme de degré 2, rappelez-vous de l’algorithme appris à l’école ou allez consulter votre mémoire numérique Wikipédia, il faut calculer le déterminant qui vaut pour le polynôme . Dans notre cas, il vaut donc :
Pour qu’un polynôme ne change pas de signe, il faut qu’il ait une racine double (le fameux cas rappelez vous!), c’est-à-dire que . Le k pour lequel est atteint ce minimum est alors . Il faut donc diviser le bâtiment en racine carrée du nombre d’étages pour aller au plus vite à la solution (on obtient alors le résultat en opérations).
Ces exemples montrent que l’on peut résoudre un même problème de façon plus ou moins rapide. Dans les cas présents, si l’on passe d’un bâtiment de 10 étages à un bâtiment qui en a 100 000, dans le premier cas, on multiplie le nombre d’opérations par 10000 alors que dans le second on le multiplie seulement par 100. Cela peut dans certains cas différencier un algorithme exécutable en temps humain d’un algorithme dont nous ne verrons jamais la fin.
Pour revenir au problème P=NP, les problèmes P sont ceux pour lesquelles ont connaît un algorithme qui ne nécessite “que” un nombre polynomial d’opérations par rapport à la taille des données d’entrée. C’est-à-dire que le nombre d’opérations qu’ils nécessitent pour des données de taille n est inférieur à pour un certain k. Les problèmes NP sont quant à eux des problèmes dont on ne connaît pas d’algorithme les résolvant en temps polynomial, mais où il est facile de vérifier si l’on a une solution (facile veut dire que cette vérification se fait en temps polynomial). Dans l’exemple de la noix de coco, même s’il faut n opérations pour résoudre le problème il n’en faut qu’une seule pour voir si la noix de coco est cassée.
Les problèmes NP sont alors des problèmes que l’on résout facilement avec de la chance : en prenant une configuration au hasard et pour peu qu’on soit par chance tombé sur la solution, on sait s’en rendre compte rapidement. Toute la question de P=NP est alors de savoir si des problèmes simples à vérifier sont simples à résoudre.
Les problèmes NP ne sont pas du tout des problèmes exotiques mis en avant par un mathématicien un peu fou, ce sont des problèmes que l’on croise tous les jours. Le plus connu, le voyageur de commerce, demande à proposer une méthode pour trouver le chemin le plus court étant donné une répartition de maisons pour que le voyageur de commerce puisse toutes les voir. On sait facilement vérifier si l’on a bien le chemin le plus court, mais on ne sait pas facilement trouver ce chemin.
Plus amusant, étant donné une liste de mots et un mot croisé vierge, trouver où il faut mettre chaque mot est un problème NP, on sait très rapidement vérifier si la grille est bien remplie, mais on ne sait pas la remplir rapidement.
Ce problème reste aujourd’hui complètement ouvert. À une époque, on pensait qu’il était vrai, aujourd’hui beaucoup pensent qu’il est faux et d’autres qu’il serait indécidable…..
Ici s’achève le dossier sur les algorithmes, j’espère vous avoir éclairé sur le sujet et surtout vous avoir démontré que l’on pouvait parler d’algorithmes sans jamais parler d’ordinateur ni de langage de programmation!
Sources bibliographiques et autres liens pour aller plus loin :
“histoires d’algorithmes : du caillou a la puce” : un excellent livre qui regorge d’exemples d’algorithmes. On y trouve le texte original, sa traduction quand c’est nécessaire et des explications historiques, c’est de loin celui qui m’al le plus servi a construire ce dossier.
“Godel Escher et Bach : Les Brins d’une Guirlande Eternelle” : un livre référence en diffusion des mathématiques qui traite sur une grande part de ce sujet. Contrairement au précédent qui a une approche très historique, celui-ci a une approche plus poétique et plus imagée tout en restant parfaitement rigoureux.
“les métamorphoses du calcul : une étonnante histoire des mathématiques” : un livre qui parle de Math et qui a eu le prix de philosophie de l’académie française! Livre qui parle de l’histoire du calcul et de la thèse de Church, ses implications, de la philosophie autour de cette hypothèse. Ce livre est écrit par un très bon pédagogue et est passionnant, pour autant, il ne faut pas oublier à la lecture que c’est le livre d’un informaticien, parfois un peu trop convaincu de la supériorité du calcul sur les mathématiques au sens large (calculables ou non).
Gilles Dowek qui a écrit le livre précédent est écoutable et visionable dans une conférence. Elle nécessite l’instalation de l’horreur “Real Player” mais je vous assure que cela vaut le coup!


 Cette semaine ce sont


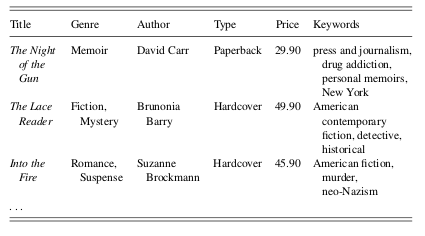
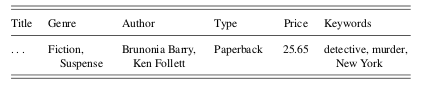
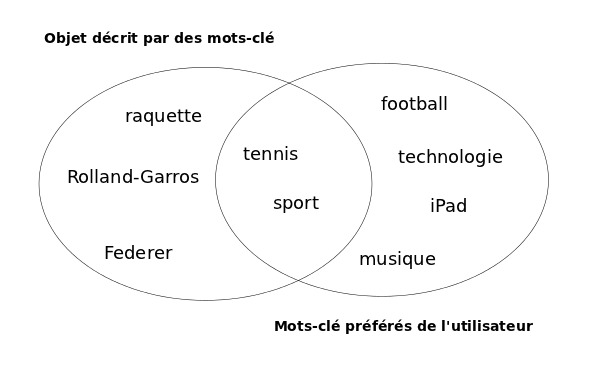
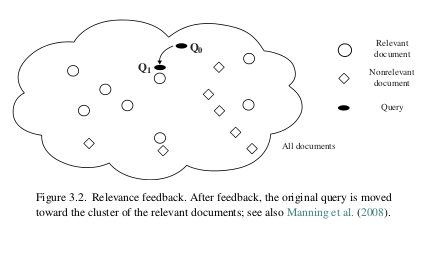
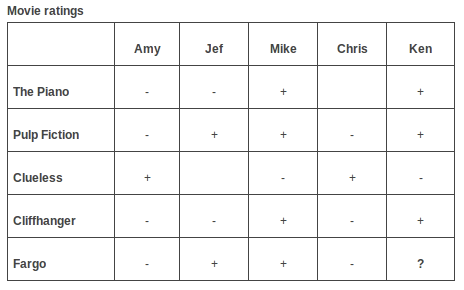
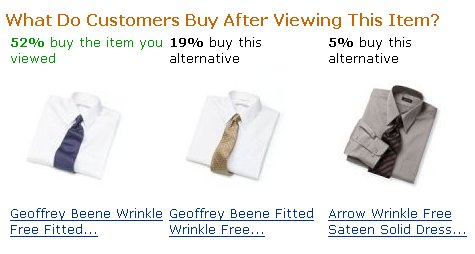
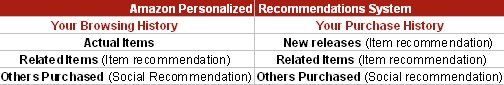
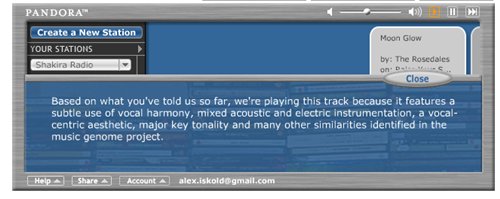



 opérations. Il s’agit alors de trouver pour quel k on effectuera le moins d’opérations.
 est supérieur à zéro pour tous les k. Comme k est supérieur à zéro, cela revient à trouver le minimum du polynôme
 .
 qui vaut
 pour le polynôme
 . Dans notre cas, il vaut donc :

 rappelez vous!), c’est-à-dire que
 . Le k pour lequel est atteint ce minimum est alors
 . Il faut donc diviser le bâtiment en racine carrée du nombre d’étages pour aller au plus vite à la solution (on obtient alors le résultat en
 opérations).
 pour un certain k. Les problèmes NP sont quant à eux des problèmes dont on ne connaît pas d’algorithme les résolvant en temps polynomial, mais où il est facile de vérifier si l’on a une solution (facile veut dire que cette vérification se fait en temps polynomial). Dans l’exemple de la noix de coco, même s’il faut n opérations pour résoudre le problème il n’en faut qu’une seule pour voir si la noix de coco est cassée.